10 · Gradientes y backpropagation
Nivel 2 — Deep learning · Ruta de Aprendizaje
Antes de empezar. El modelo lineal, MSE y el bucle del módulo 09. Las derivadas se construyen aquí como pendientes; no necesitas haber usado autograd.
En el capítulo anterior, backward() calculaba una señal que el optimizador
usaba para mover los pesos. ¿Cómo sabe hacia dónde moverlos? Empecemos con una
curva de una sola variable; después seguiremos esa señal a través de varias
operaciones.
Una pendiente indica qué cambio probar
Imagina que el único peso del modelo es w y su pérdida es L(w)=(w−1)².
En w=−1, la pérdida vale 4. Mover un poco w hacia la derecha la reduce;
moverlo hacia la izquierda la aumenta. La derivada describe esa pendiente
local: cuánto cambia la pérdida por una variación pequeña del peso.
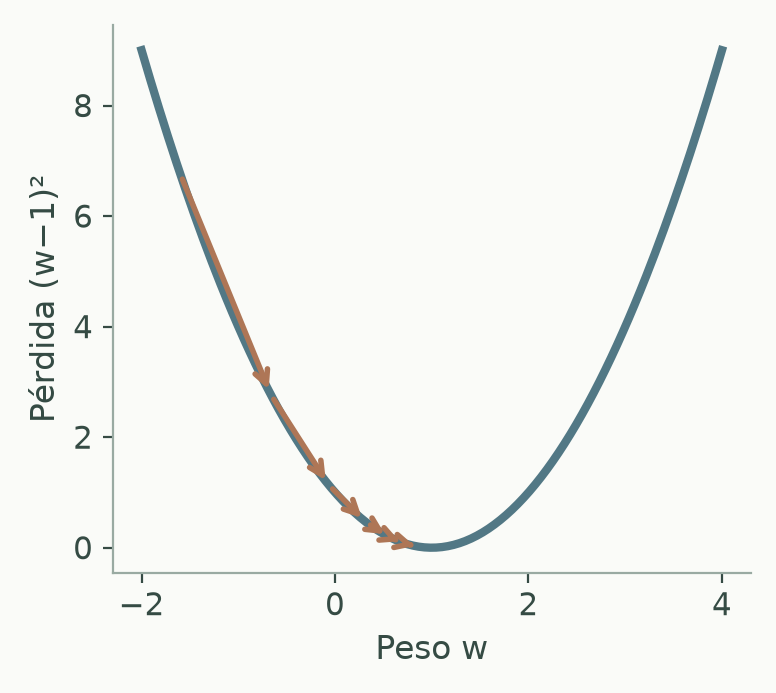
Las flechas van hacia el mínimo w=1. Se acortan porque la pendiente se hace
menor al acercarse. Mejorar la pérdida de entrenamiento no garantiza mejorar
en datos nuevos: compararemos esas curvas en 11 - Entrenar de verdad.
Una pendiente puede aproximarse sin una fórmula especial: evalúa un poco antes y un poco después y divide la diferencia por la distancia recorrida:
f'(x) ≈ (f(x+h) − f(x−h)) / (2h)
Para f(x)=x², en x=3, h=0.001 da aproximadamente 6. Cerca de ese punto,
reducir x en 0.01 reduce f en aproximadamente 0.06. La aproximación es local:
no describe lo que pasará con un salto arbitrariamente grande.
Con varios pesos calculamos una pendiente respecto de cada uno, manteniendo
los demás fijos. Ese conjunto de pendientes es el gradiente. La notación
∂L/∂w expresa cuánto cambia la pérdida L al variar el peso w.
El descenso de gradiente propone la actualización:
peso_nuevo = peso_actual − learning_rate × gradiente
El signo menos orienta el paso hacia la bajada local; el learning rate regula su tamaño. Un paso demasiado grande puede pasar de largo y aumentar la pérdida. En una red tampoco hay garantía de llegar al mejor mínimo posible. Y en entrenamiento por lotes el gradiente se estima con los ejemplos del lote: no cada paso tiene por qué reducir la pérdida del conjunto completo.
La regla de la cadena es todo el truco
Si una operación alimenta a otra, un cambio atraviesa ambas. Por ejemplo, si la primera operación convierte un pequeño cambio de entrada en uno dos veces mayor, y la siguiente lo triplica, el cambio final es seis veces el inicial. La regla de la cadena formaliza esa multiplicación de sensibilidades locales.
Por ejemplo, si u depende de x y la pérdida L depende de u, tenemos
la cadena x → u → L. Sus pendientes se combinan así:
∂L/∂x = ∂L/∂u · ∂u/∂x
Backpropagation, o propagación hacia atrás, aplica esta regla desde la
pérdida hacia las entradas. Primero obtiene ∂L/∂u, la multiplica por la
derivada local de la operación anterior y continúa. Reutiliza resultados
intermedios para no repetir trabajo. Cada capa aporta las derivadas de
su operación. Si una variable llega por varios caminos, se suman sus
contribuciones; en capas vectoriales se combinan matrices de derivadas.
No suele ser necesario programar la derivada de cada capa: al escribir su
forward con operaciones diferenciables de PyTorch, autograd conecta las reglas
de derivación de esas operaciones. Un módulo también puede contener operaciones
sin gradiente; envolverlas en una clase no las vuelve diferenciables.
Comprobarlo: derivada a mano contra autograd
Nada convence como verlo coincidir. Toma f(x) = (3x + 2)². A mano, con la
regla de la cadena: la derivada de u² es 2u, y la de 3x+2 es 3, así que
f'(x) = 2(3x+2)·3 = 6(3x+2). En x = 2 eso da 6 · 8 = 48.
# bloque: fragmento
import torch

x = torch.tensor(2.0, requires_grad=True)
f = (3 * x + 2) ** 2
f.backward()
print(x.grad.item())          # 48.0
print(6 * (3 * 2 + 2))        # 48
requires_grad=True pide seguir los cálculos que dependen de x. Durante el
forward, autograd registra operaciones; backward() recorre ese grafo en
sentido inverso y acumula en x.grad el resultado. No actualiza x: esa es otra
operación, que normalmente realiza el optimizador.
Podemos contrastar tres caminos hacia 48: la cuenta a mano, una diferencia
finita y autograd. Cerca de puntos suaves deben concordar aproximadamente;
la diferencia finita además depende del tamaño de h y del redondeo.
Un paso completo sobre los mismos tres ejemplos
Antes de ampliar la red, cerremos la cuenta del modelo del módulo 09.
Para una fila, predicción = wx+b y error = predicción−y.
La pérdida de la fila es error². La cadena empieza con 2×error;
la derivada de la predicción respecto de w es x, y respecto de b es 1.
Por eso esa fila aporta 2×error×x a w y 2×error a b.
Como MSE promedia tres filas, también promediamos sus aportes:
Partimos otra vez de w=b=0, así que las tres predicciones son cero.
| x, y | Aporte a w | Aporte a b |
|---|---|---|
| −1, −1 | −2 | 2 |
| 0, 1 | 0 | −2 |
| 1, 3 | −6 | −6 |
| Promedio | −8/3 | −2 |
Con learning rate 0.1, w pasa a 0−0.1×(−8/3)=4/15 y b a 0.2.
Las nuevas predicciones son aproximadamente [-0.0667, 0.2, 0.4667].
MSE baja de 3.6667 a 2.6430: un solo paso acerca las respuestas, sin
haber encontrado todavía w=2 y b=1.
# bloque: probado; id: paso_lineal_manual
import torch

X = torch.tensor([[-1.], [0.], [1.]], dtype=torch.float64)
y = torch.tensor([[-1.], [1.], [3.]], dtype=torch.float64)
w = torch.tensor(0., dtype=torch.float64, requires_grad=True)
b = torch.tensor(0., dtype=torch.float64, requires_grad=True)
antes = ((X * w + b - y) ** 2).mean()
antes.backward()
grad_w, grad_b = w.grad.item(), b.grad.item()
with torch.no_grad():
    w -= 0.1 * w.grad
    b -= 0.1 * b.grad
    despues = ((X * w + b - y) ** 2).mean()
print(grad_w, grad_b)                  # -2.666666..., -2.0
print(antes.item(), despues.item())   # 3.666666..., 2.642962...
no_grad() permite modificar los parámetros sin registrar esa modificación
como parte de la función que acabamos de derivar. En el módulo 09, SGD realiza
esa actualización. Las filas comparten w y b: sus caminos hacia cada parámetro
se reúnen y suman. La media aporta después el factor 1/3.
También puede haber varios caminos dentro de una sola expresión. En
L=w*w+w, w aparece dos veces en el producto y una en la suma. En w=2,
los aportes son 2, 2 y 1: el gradiente total es 5. Olvidar una rama daría
una derivada distinta. Autograd conserva esas dependencias, no solo los valores.
El perceptrón, y por qué hacen falta las activaciones
Una neurona toma varias entradas, las pondera y añade un sesgo:
z = w₁x₁ + w₂x₂ + … + b. Cada peso regula cuánto aporta una entrada;
el sesgo b permite desplazar la respuesta. Una activación transforma z
antes de enviarlo a la siguiente capa.
nn.Linear(4, 2) calcula dos sumas de ese tipo a partir de cuatro features.
Tiene 2×4 pesos y dos sesgos. Si apilamos estas transformaciones sin una
activación no lineal, siguen siendo una sola transformación afín: una suma
ponderada más un sesgo. Agregar capas así cambia la parametrización, pero no
permite representar una frontera curva.
XOR permite verlo con cuatro puntos: (0,0) y (1,1) pertenecen a una clase;
(0,1) y (1,0) a la otra. Ninguna recta separa esas dos diagonales. Un MLP
con activaciones no lineales puede construir varias regiones y representarlas.
Aprender sus pesos mediante entrenamiento sigue siendo un problema distinto
de que la arquitectura pueda expresar la respuesta.
Tres activaciones habituales:
| Activación | Rango | Cuándo |
|---|---|---|
ReLU max(0, z) | [0, ∞) | deja pasar positivos y convierte negativos en cero; frecuente en capas ocultas |
Sigmoide 1/(1+e⁻ᶻ) | (0, 1) | convierte un logit en probabilidad binaria; también aparece en compuertas |
| Tanh | (−1, 1) | comprime la respuesta conservando ambos signos; usada, por ejemplo, en redes recurrentes |
Sigmoide y tanh saturan: al acercarse a los extremos de su rango, su derivada es casi cero, y al multiplicar muchas derivadas casi cero por la regla de la cadena el gradiente se desvanece antes de llegar a las primeras capas. ReLU tiene derivada 1 en la región positiva, pero 0 en la negativa: tampoco elimina todos los problemas de gradientes y puede dejar neuronas inactivas.
Las pérdidas: convertir una predicción en un error
La pérdida debe conectar lo que devuelve la red con la respuesta conocida. En regresión podemos restar predicción y objetivo. En clasificación necesitamos penalizar que el modelo asigne poca probabilidad a la clase correcta.
| Pérdida | Qué calcula | Consecuencia |
|---|---|---|
| MSE | promedio de errores al cuadrado | un error de 10 pesa cien veces uno de 1 |
| MAE | promedio de errores absolutos | un error de 10 pesa diez veces uno de 1 |
| Cross-entropy | menos el logaritmo de la probabilidad de la clase correcta | equivocarse con mucha confianza recibe una penalización grande |
Si debieras predecir una única constante para un conjunto de valores, la media minimiza MSE y una mediana minimiza MAE. Una red usa las entradas para variar su predicción; estas pérdidas favorecen respuestas distintas cuando hay ruido o valores extremos.
La pérdida y la métrica del módulo 04 están relacionadas, pero no siempre son
idénticas. Accuracy cambia solo cuando cambia la clase elegida: ofrece poca
información para un gradiente. Cross-entropy permite entrenar incluso antes de
que cambie ese acierto. En Ghost of the Machine, el promedio de
exp(−|error|/100) valora la distancia absoluta de forma no lineal: MAE es una
pérdida posible, no una optimización equivalente del score. La comparación
final debe usar la métrica que realmente se evalúa.
Logits: la entrada que espera cross-entropy
Probabilidad y logaritmos para aprender construyó softmax desde
exponenciales y una división por la suma. Para logits [2,0.5,−1],
restar el máximo da [0,−1.5,−3]; exp produce aproximadamente
[1,0.2231,0.0498]. Al dividir por la suma obtenemos
[0.7856,0.1753,0.0391]. Si la clase correcta es 0, la pérdida es
−log(0.7856)≈0.2413. La función de biblioteca combina esos pasos
de forma numéricamente estable.
Un logit es una puntuación real sin normalizar. Para tres clases, la red
podría devolver [2.0, 0.5, −1.0]: la primera tiene mayor puntuación, pero esos
números todavía no son probabilidades. Softmax los convierte en valores
positivos que suman uno, amplificando las diferencias mediante exponenciales.
cross_entropy combina esa normalización con el logaritmo de forma numéricamente
estable. Espera logits y, en este ejemplo, un índice de clase por muestra.
Pasarle probabilidades calculadas antes aplica otra normalización: cambia la
pérdida y su gradiente, aunque no dé error.
# bloque: probado; id: logits
import math
import torch
import torch.nn as nn

logits = torch.tensor([[2.0, 0.5, -1.0]])
y = torch.tensor([0])

print(nn.functional.cross_entropy(logits, y).item())   # 0.2413  ← correcto

probs = torch.softmax(logits, dim=1)
print(nn.functional.cross_entropy(probs, y).item())    # 0.7017  ← mal, sin avisar
print(-math.log(probs[0, 0].item()))                   # 0.2413  ← la cuenta a mano
En un clasificador multiclase entrenado con esta pérdida, la cabeza puede ser
una nn.Linear que devuelve (lote, n_clases) sin softmax final. Para elegir
la clase basta argmax: softmax no cambia qué puntuación es la mayor. Si queremos
probabilidades para un umbral o un gráfico, sí lo aplicamos al predecir:
# bloque: fragmento
with torch.no_grad():
    probs = torch.softmax(modelo(X_val), dim=1)[:, 1]
Ese [:, 1] selecciona la probabilidad de la clase 1. Otra formulación binaria
usa un logit por ejemplo con BCEWithLogitsLoss, que incorpora la sigmoide.
No se intercambian ambas pérdidas sin revisar la forma de salida y el formato
de las etiquetas.
Las otras dos trampas
1. Gradientes que explotan. El espejo del desvanecimiento: si los factores
de la cadena son grandes, el gradiente puede crecer hasta producir pasos
inestables o valores no finitos, como nan. Una pérdida no finita también puede venir de datos ausentes o de una
operación inválida: revisa entradas y primera operación que produce el error.
Si el origen son gradientes enormes, prueba bajar el learning rate (módulo 11)
o recortar su norma con torch.nn.utils.clip_grad_norm_.
2. backward() dos veces sobre el mismo grafo. PyTorch libera por defecto
los valores intermedios necesarios para derivar. Reutilizar esa misma pérdida
puede dar Trying to backward through the graph a second time.
zero_grad() solo limpia gradientes acumulados; no reconstruye el grafo.
En un paso nuevo vuelve a ejecutar el forward. Si arrastras estados entre
iteraciones, revisa dónde corresponde detach(); para registrar números usa
.item(). retain_graph=True solo corresponde si necesitas derivar de nuevo
el mismo forward, y conserva memoria.
# bloque: probado; id: autograd_recalcular
import torch

x = torch.tensor(2.0, requires_grad=True)
f = (3 * x + 2) ** 2
f.backward()
x.grad.zero_()                  # limpia gradientes, no el grafo anterior
f_nueva = (3 * x + 2) ** 2       # forward nuevo
f_nueva.backward()
assert x.grad.item() == 48.0
🏋️ Práctica
Primero, cambiar un paso
Repite la cuenta anterior con learning rate 0.2. ¿Se duplican los gradientes o el desplazamiento de los pesos? Luego usa 2.0 y calcula la nueva pérdida.
Para contrastar
Los gradientes iniciales siguen siendo −8/3 y −2: todavía se calculan en w=b=0. Con 0.2, w=8/15 y b=0.4. Con 2.0, w=16/3 y b=4; MSE resulta
443/27 ≈ 16.4074, mayor que 11/3. La pendiente describe un cambio local; un salto grande puede atravesar el mínimo.
Para profundizar
| # | Ejercicio | Fuente | Qué practica |
|---|---|---|---|
| 1 | ⭐⭐ micrograd: backprop desde cero, línea por línea | Karpathy — Zero to Hero, clase 1 | construir un motor de derivación escalar |
| 2 | Deriva a mano tres funciones y compáralas con autograd | — | que coincida el número |
| 3 | Implementa un perceptrón con NumPy: forward y backward a mano, sin PyTorch | — | entender qué automatiza autograd |
| 4 | Entrena el XOR con y sin activaciones y comprueba que sin ellas no puede | MLP | la razón de ser de las no linealidades |
| 5 | Provoca una pérdida nan subiendo el learning rate, y arréglala | — | reconocer gradientes que explotan |
Micrograd permite ver el grafo completo de una red pequeña. Seguir cómo una variable recibe contribuciones por dos caminos conecta el programa con la regla de la cadena.
🎯 Mini-desafío (formato IOAI)
Tarea: implementa
descenso_gradiente(f, x0, lr, pasos)que minimice una función de una variable calculando el gradiente con autograd, y úsala para encontrar el mínimo de(x−3)²,2(x+1)²+4y(x−0.5)²+2, desdex0=0, conlr=0.1y 100 pasos. Métrica: error absoluto en la posición del mínimo menor que1e-4. Referencia: los mínimos están en3,−1y0.5; sin actualizar, el baselinex0=0tiene errores3,1y0.5.También puedes graficar la trayectoria para tres learning rates — uno muy chico, uno bueno, uno muy grande. Vas a ver los tres comportamientos que el módulo 11 va a nombrar: lento, sano y divergente.
Para explorar
Dibuja la parábola del mini-desafío y los primeros cinco pasos de descenso. ¿Qué cambia al duplicar el learning rate, y qué permanece igual en el gradiente?
Compara derivación a mano, diferencias finitas y autograd en la misma función. Busca un punto donde ReLU no sea derivable y observa la convención de PyTorch.
← 09 - Tensores y PyTorch · Ruta de Aprendizaje · 11 - Entrenar de verdad →