09 · Tensores y PyTorch
Nivel 2 — Deep learning · Ruta de Aprendizaje
Antes de empezar. Arreglos y formas del módulo 00 y la separación entre ajustar y predecir del 02. Aquí construiremos el primer entrenamiento en CPU; el módulo 10 explicará cómo se calculan sus gradientes.
En los modelos anteriores, fit ocultaba la actualización de parámetros.
PyTorch permite escribirla y observarla. Seguiremos un lote desde que se carga
hasta que modifica los pesos: las formas de los arreglos siguen siendo las del
módulo 00, y ahora también importa cómo se construyó cada cálculo.
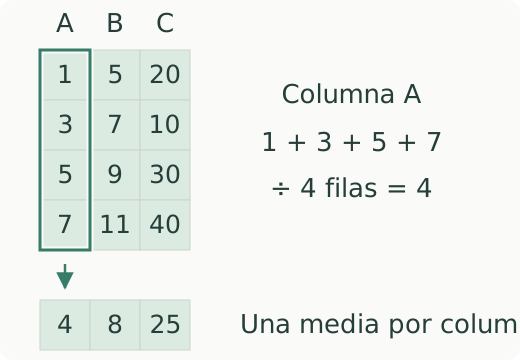
En la columna A, (1 + 3 + 5 + 7) / 4 = 4. Las medias de A, B y C son 4, 8 y 25; no se mezclan columnas.
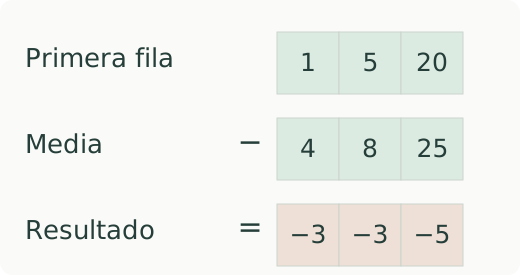
La primera fila pasa de [1, 5, 20] a [−3, −3, −5]: cada valor resta la media de su propia columna.
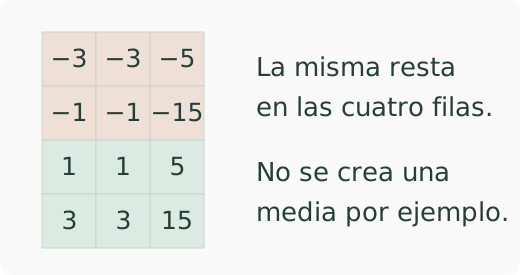
Broadcasting reutiliza la forma (1, 3) al operar con (4, 3). El resultado conserva cuatro filas y tres columnas; la media de cada columna queda en cero.
En la figura, una fila de tres medias se reutiliza en las cuatro filas de X:
el primer resultado es (1−4, 5−8, 20−25). No se mezclan columnas. PyTorch usa
esta misma regla de broadcasting para combinar formas compatibles.
De arreglos a tensores
Un tensor es un arreglo de números con uno o más ejes; un escalar tiene cero ejes. Muchas operaciones de PyTorch se parecen a las de NumPy, aunque los nombres y algunos valores por defecto cambian. Aquí nos interesan dos capacidades:
- Puede vivir en la GPU.
- Puede recordar cómo se calculó, para que se le puedan sacar gradientes.
# bloque: fragmento
import numpy as np
import torch

a = torch.tensor([[1., 2., 3.],
                  [4., 5., 6.]])
print(a.shape, a.dtype, a.device)     # torch.Size([2, 3]) torch.float32 cpu

# ida y vuelta con NumPy (comparten memoria: cuidado)
t = torch.from_numpy(np.array([1., 2., 3.]))
v = t.numpy()
En este ejemplo, torch.tensor recibe decimales de Python y crea float32
con la configuración habitual. NumPy crea float64 a partir de una lista así.
Una lista de enteros tiene otro tipo, y torch.from_numpy conserva el tipo del
arreglo: t es float64. Cuando una capa y sus entradas requieren el mismo
tipo, conviene elegirlo explícitamente, por ejemplo dtype=torch.float32.
from_numpy comparte memoria con el arreglo original. La conversión t.numpy()
del ejemplo también comparte esos datos: modificar uno puede modificar el otro.
torch.tensor(arreglo) crea una copia. Para convertir un tensor que participa
en gradientes o vive en GPU, se usa tensor.detach().cpu().numpy(); el traslado
a CPU y la desconexión del gradiente cumplen funciones distintas.
Leer formas en PyTorch
NumPy usa axis para elegir un eje; muchas operaciones de PyTorch lo llaman
dim. Reducirlo combina sus valores. dim=-1 nombra el último eje y -2
el penúltimo: no son números de ejemplos. En una tabla, reducir el último
eje resume cada fila.
# bloque: probado; id: formas_pytorch
import torch

tabla = torch.tensor([[1., 2., 3.], [4., 5., 6.]])
por_fila = tabla.sum(dim=-1)
con_eje = tabla.sum(dim=-1, keepdim=True)
print(por_fila, por_fila.shape)  # [6,15], (2,)
print(con_eje, con_eje.shape)    # [[6],[15]], (2,1)
columna = por_fila.unsqueeze(-1)
print(columna.shape)            # (2,1): añade un eje, no nuevos valores
print(tabla.transpose(0, 1))     # [[1,4],[2,5],[3,6]]
keepdim=True conserva con tamaño uno el eje reducido. unsqueeze añade un
eje de tamaño uno al tensor ya calculado; squeeze(dim) puede quitarlo si
ese eje mide uno. Elegirlo explícitamente evita borrar por accidente el
eje del lote cuando solo hay un ejemplo. reshape conserva la cantidad
de elementos; transpose cambia qué eje ocupa cada lugar.
Un modelo que empieza equivocándose
Tenemos tres observaciones: para entradas −1, 0 y 1, las respuestas son −1,
1 y 3. Queremos ajustar predicción = w × entrada + b. En estos datos la
regla es y=2x+1, pero el entrenamiento solo recibirá los pares de números.
Empecemos con w=0 y b=0. El modelo predice cero en las tres filas:
| Entrada | Respuesta | Error² |
|---|---|---|
| −1 | −1 | 1 |
| 0 | 1 | 1 |
| 1 | 3 | 9 |
La pérdida MSE es (1+1+9)/3 = 11/3. Resume el error de esas tres
predicciones. Ajustar significa cambiar w y b, manteniendo los datos.
Una nn.Linear(1, 1) guarda justamente un peso y un sesgo para esta regla.
El bucle de entrenamiento: del error a un cambio de pesos
Primero hacemos una predicción (forward) y calculamos su pérdida.
backward() obtiene las pendientes respecto de w y b; todavía no cambia los
pesos. El optimizador SGD los actualiza restando learning_rate × gradiente.
El siguiente forward usa esos pesos nuevos. Este programa es completo:
# bloque: probado; id: primer_entrenamiento
import torch
from torch import nn

X = torch.tensor([[-1.], [0.], [1.]])   # (3, 1): tres ejemplos, una variable
y = torch.tensor([[-1.], [1.], [3.]])   # una respuesta por ejemplo
modelo = nn.Linear(1, 1)
with torch.no_grad():
    modelo.weight.zero_()
    modelo.bias.zero_()
perdida = nn.MSELoss()
optimizador = torch.optim.SGD(modelo.parameters(), lr=0.1)
historial = []
for paso in range(100):
    salida = modelo(X)
    valor = perdida(salida, y)
    historial.append(valor.item())    # pérdida ANTES de esta actualización
    optimizador.zero_grad()
    valor.backward()
    optimizador.step()
with torch.no_grad():
    pred_final = modelo(X)
print(modelo.weight.item(), modelo.bias.item())  # aproximadamente 2 y 1
print(pred_final.flatten())                     # aproximadamente [-1, 1, 3]
parameters() entrega los pesos que SGD podrá modificar. lr=0.1 fija el
tamaño del paso; en el módulo 10 veremos por qué uno muy grande puede empeorar
la pérdida. Inicializar en cero sirve para esta regresión, pero no es una
regla general para capas ocultas de una red.
La capa conserva weight y bias. modelo(X) devuelve predicciones, sin
reemplazar X ni actualizar los pesos por sí mismo. La pérdida es un tensor
con un número; .item() obtiene un número de Python para registrarlo. El
optimizador es otro objeto, con referencias a los parámetros que puede mover.
| Operación | Qué cambia |
|---|---|
| Forward | calcula predicciones con los pesos actuales |
backward() | acumula derivadas en .grad |
step() | modifica los pesos usando las derivadas |
zero_grad() | limpia gradientes; conserva los pesos |
PyTorch acumula cada gradiente en .grad: zero_grad() limpia los
anteriores para que este paso use solamente el cálculo actual. Puede ir antes
del forward; debe ocurrir antes del backward que queremos usar por separado.
En el módulo 15 acumularemos varios lotes deliberadamente.
Aquí bajar MSE confirma que ajustamos esos tres ejemplos. No demuestra
generalización a datos reales: todos siguen una regla exacta y no hay ruido.
Puedes probar modelo(torch.tensor([[2.]])): la regla del ejemplo da 5.
En una tarea real se reservarían datos como en el módulo 05. La receta
Bucle de entrenamiento en PyTorch reúne un ciclo con entrenamiento y validación.
Dataset y DataLoader: dividir los mismos datos en lotes
Hasta ahora cada actualización usó las tres filas juntas. Un lote es el grupo usado para calcular una pérdida y su gradiente. Podemos dividir las mismas tres observaciones en lotes de dos:
# bloque: probado; id: primeros_lotes
from torch.utils.data import DataLoader, TensorDataset

# Continúa con X e y del programa anterior.
cargador = DataLoader(TensorDataset(X, y), batch_size=2, shuffle=False)
lotes = list(cargador)
for lote_X, lote_y in lotes:
    print(lote_X.flatten().tolist(), lote_y.flatten().tolist())
# [-1.0, 0.0] [-1.0, 1.0]
# [1.0] [3.0]
TensorDataset conserva juntas entrada y respuesta; DataLoader selecciona
índices y agrupa las filas. La última tanda tiene solo una: batch_size=2
es el máximo, no una promesa de que todos los lotes tendrán ese tamaño.
Una época recorre el cargador. Para entrenar por lotes, el cuerpo del
programa anterior iría dentro de ese recorrido y usaría lote_X, lote_y.
Habría dos actualizaciones por época, en lugar de una sobre las tres filas.
shuffle=True cambia el orden entre épocas sin separar entradas de respuestas.
Se suele usar con ejemplos independientes; puede ser inadecuado si el modelo
mantiene estado temporal entre lotes. drop_last=True omitiría aquí la última
fila. En validación, conservar el orden facilita alinear predicciones e IDs;
barajar no cambia una media bien calculada, pero comparar contra etiquetas
recogidas en otro orden sí cambia su significado.
El dispositivo
# bloque: fragmento
dispositivo = "cuda" if torch.cuda.is_available() else "cpu"

modelo = modelo.to(dispositivo)
X = X.to(dispositivo)
y = y.to(dispositivo)
optimizador = torch.optim.SGD(modelo.parameters(), lr=0.1)
En una capa como nn.Linear, sus pesos y las entradas deben estar en el mismo
dispositivo. También hay que ubicar allí las etiquetas usadas para calcular la
pérdida. .to(dispositivo) devuelve el tensor en el dispositivo solicitado;
por eso se asigna el resultado. Si aparece un error de dispositivo, inspecciona
los tensores concretos que llegan a esa operación.
El condicional elige CUDA si está disponible y CPU en caso contrario. Así podemos estudiar ejemplos pequeños en una máquina sin GPU. Una GPU puede acelerar lotes grandes, pero transferir datos también cuesta; no toda operación será más rápida. Esta preparación va antes del entrenamiento que quieras realizar en ese dispositivo: crea el optimizador después de ubicar los parámetros. Si cargas lotes en CPU, mueve cada lote y sus etiquetas antes del forward. La plantilla del repositorio incluye esta selección:
Ampliación: cargar archivos cuando hacen falta
Para cargar archivos a medida que hacen falta, podemos definir un Dataset.
cargar representa una función que tendrás que adaptar al formato de archivo:
# bloque: fragmento
from torch.utils.data import Dataset

class MiDataset(Dataset):
    def __init__(self, rutas, etiquetas):
        self.rutas = rutas
        self.etiquetas = etiquetas

    def __len__(self):
        return len(self.rutas)

    def __getitem__(self, i):
        x = cargar(self.rutas[i])          # leer del disco recién acá
        return x, self.etiquetas[i]
__getitem__(i) define cómo obtener un ejemplo. El cargador decide qué
índices pedir. En una época común sin reemplazo recorre cada ejemplo una vez,
pero un muestreo personalizado puede repetirlos y drop_last=True puede omitir
el lote final. Una época es un recorrido definido por ese cargador, no una
promesa de que todos los programas llamen exactamente una vez a cada índice.
Guardar rutas y metadatos en __init__ cuesta poco. Cargar todas las imágenes
allí puede agotar RAM; leerlas al pedirlas mantiene acotado el uso de memoria.
Una transformación fija puede precalcularse o cachearse si cabe, mientras que
una transformación aleatoria suele repetirse durante el entrenamiento.
shuffle=True mezcla el orden de los ejemplos: suele ser útil cuando pueden
tratarse de forma independiente. Si el modelo conserva estado temporal entre
lotes, barajar puede romper el problema. En validación, shuffle=False facilita
conservar ids y orden. Barajar no cambia una media correctamente calculada,
pero sí desalinearía predicciones y etiquetas recogidas por separado.
.item(), .detach() y no_grad()
El grafo de cálculo registra operaciones conectadas por sus entradas y salidas. Estas tres herramientas permiten separar entrenamiento y observación:
# bloque: fragmento
total += valor.item()          # sacar UN número de un tensor de un elemento
vector = tensor.detach()       # un tensor igual, pero fuera del grafo

with torch.no_grad():          # bloque entero sin construir grafo: para EVALUAR
    predicciones = modelo(X_val)
.item() obtiene un número de un tensor con un solo elemento; sirve para
registrar una pérdida. .detach() produce un tensor desconectado del historial
de gradientes, pero comparte sus datos: no es una copia independiente.
no_grad() evita registrar nuevas operaciones para derivarlas, por ejemplo
al predecir en validación.
Guardar tensores conectados al grafo puede retener memoria que no necesitas;
backward() libera normalmente los valores intermedios usados para derivar,
pero no conviene conservar historiales completos para registrar números.
no_grad() reduce ese trabajo en evaluación. El modo de capas como dropout se
controla aparte con eval(), como veremos en el módulo 11.
⚠️ Las tres trampas (los tres tracebacks)
1. Forma.
# bloque: error-deliberado; id: forma_incorrecta
import torch.nn as nn
capa = nn.Linear(4, 2)
capa(torch.randn(3, 5))
# RuntimeError: mat1 and mat2 shapes cannot be multiplied (3x5 and 4x2)
El lote tiene tres ejemplos con cinco features, pero nn.Linear(4, 2) espera
cuatro features por ejemplo y devuelve dos. Con una entrada (3, 4) produciría
(3, 2). La corrección depende de qué representan las columnas: cambiar un
reshape hasta que ejecute puede ocultar que mezclaste ejemplos y features.
2. Tipo. Una capa lineal con pesos float32 no admite sin más entradas
float64. Para cross_entropy con una clase correcta por ejemplo, las etiquetas
son índices enteros long, entre 0 y n_clases−1. Los objetivos de regresión
son valores flotantes; otras variantes de clasificación usan distribuciones
como objetivo y tienen otro contrato.
3. Dispositivo. Puede faltar mover un lote, una etiqueta o un tensor creado
dentro del modelo. Lee qué operación falla y compara los device de sus
entradas, junto con shape y dtype.
Estas propiedades expresan decisiones del problema: qué es una muestra, qué significa su respuesta y dónde se realiza el cálculo. Interpretarlas permite reparar la causa del error.
🏋️ Práctica
Una primera variación local
Cambia las respuestas del programa a [-4, -1, 2], conservando las entradas.
Antes de ejecutarlo, busca la recta que pasa por los tres pares. ¿Qué debería
predecir para entrada 2? Después prueba lotes de tamaño 2: compara el número
de actualizaciones, no solo el número de épocas.
Para contrastar
La regla es
y=3x−1, así que w se acerca a 3, b a −1 y la predicción a 5. El cargador hace dos lotes por época. Dar dos pasos sucesivos no equivale en general a dar uno con los tres ejemplos: el segundo ya usa otros pesos.
Para profundizar
| # | Ejercicio | Fuente | Qué practica |
|---|---|---|---|
| 1 | Tutorial de PyTorch: Tensors y Datasets | pytorch.org/tutorials | conectar los conceptos con la API oficial |
| 2 | Reescribe tu solución del módulo 02 con una nn.Linear y el bucle a mano | Bucle de entrenamiento en PyTorch | el ciclo entero, sin magia |
| 3 | ⭐ Ajusta y = 2x + 1 y comprueba que el modelo aprende w≈2, b≈1 | — | ver que el bucle funciona de verdad |
| 4 | Escribe un Dataset propio que lea imágenes del disco | Kaggle Digit Recognizer | el caso en que los datos no caben |
| 5 | Provoca los tres tracebacks a propósito y aprende a leerlos | — | que dejen de darte miedo |
En el quinto ejercicio, dos arreglos con la misma cantidad de números pueden representar problemas distintos. Explica qué significa cada eje antes de proponer una forma que la capa acepte.
🎯 Mini-desafío (formato IOAI)
Este desafío amplía el bucle de la clase. Conviene retomarlo después del módulo 10, que introduce las capas y activaciones de un MLP.
Tarea principal: Robot Chasing (IOAI 2026, individual). Predecir la próxima acción de cada uno de seis robots. Métrica: promedio de las seis accuracies por robot. Baseline local: evalúa la acción constante
0en tu propia validación. Separa el 20% de las observaciones con semilla 0, manteniendo representados los robots; si identificas observaciones de un mismo episodio, separa por episodio para evitar fuga. El número de ejemplos y el resultado de cada robot permiten interpretar qué está resumiendo el promedio.Aplana la grilla
8×8×2y añade representaciones derobot_id,directionycarrying. Son categorías, no magnitudes ordenadas: una representación one-hot pone un 1 en la categoría elegida y ceros en las demás. El módulo 12 compara esa idea con embeddings. Entrena un MLP con el bucle a mano. Como primera adaptación omite el lenguaje y mide qué se pierde: no asumas que esta simplificación superará el baseline oficial.
Extensión distinta: Robot Delivery Academy (at-home). Aquí una política controla al robot durante episodios y se evalúan entregas exitosas. Requiere integrar la política con el simulador y ejecutar episodios completos. No uses la accuracy de seis robots de Chasing como métrica de Delivery; una buena predicción de acciones aisladas no prueba que complete una entrega. Reserva esta extensión para después de validar el flujo de inferencia del simulador.
Para explorar
Cambia una sola dimensión, un dtype y un dispositivo en el bucle. Antes de correr, anticipa qué operación fallará y qué información del traceback permite localizarla.
Baraja un cargador de validación conservando juntos datos y etiquetas; después compara contra etiquetas guardadas en otro orden. El contraste explica por qué el orden importa para alinear filas, aunque no cambie una media bien calculada.
← 08 - Sin etiquetas · Ruta de Aprendizaje · 10 - Gradientes y backpropagation →