03 · La competencia y la estrategia
Nivel 1 — El piso · Ruta de Aprendizaje
En el módulo anterior comparamos modelos mediante accuracy. En una competencia hay otra capa: convertir el resultado de cada tarea a puntos que se puedan sumar. La calidad medida, los puntos normalizados y la posición en un ranking son tres cosas distintas. Entender esa separación evita comparar números que pertenecen a escalas o evaluaciones diferentes.
Entrenar un modelo es una de las formas de resolver tareas IOAI. También hay búsqueda, interacción y uso de modelos ya entrenados. La tabla de las seis tareas de 2026 muestra qué papel tiene el entrenamiento en cada una, con enlaces a los enunciados.
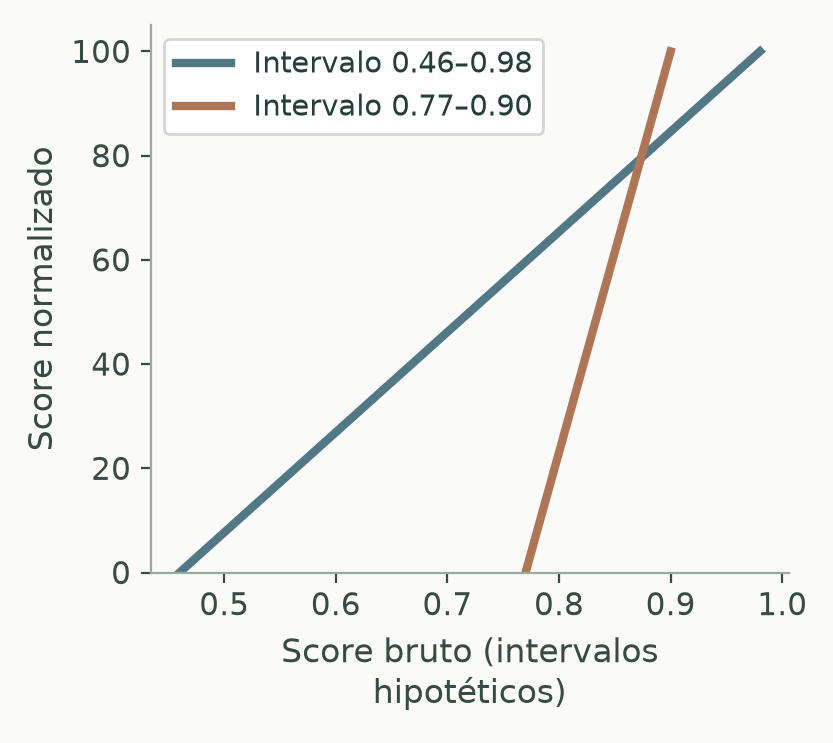
La primera figura convierte la misma mejora bruta usando dos intervalos. La comparación de sumas que veremos más abajo muestra que mejorar un poco tres tareas no siempre supera una mejora grande en una. Ningún dibujo dice cuánto costará conseguir esas mejoras; esa es otra pregunta.
De un score bruto a una escala común
Una métrica es la regla que asigna un número a las predicciones. Llamaremos score bruto a ese resultado antes de normalizarlo. En los ejemplos siguientes, un score mayor es mejor. Si un enunciado parte de un error que quiere minimizar, hay que respetar su conversión a score, no insertar ese error sin más en otra fórmula.
Un baseline local ayuda a comparar experimentos. El Baseline de la fórmula oficial es el score de la referencia que fija la tarea. Para las reglas 2026, la parte lineal de la normalización se expresa así:
Norm = 100 × (TuScore − Baseline) / (Max − Baseline)
Max  = max(0.9 × ScoreComité, mejor score bruto de un concursante)
El numerador mide cuánto avanzaste desde la referencia. El denominador es el
ancho del intervalo elegido. Si Max > Baseline, avanzar la mitad del intervalo
da 50 puntos, empatar Baseline da cero y alcanzar Max da 100 en esa expresión.
Los fallos de ejecución, límites y demás reglas se consultan en
Formato IOAI y estrategia.
Para verlo sin entrenar nada, supón Baseline=0.77, Max=0.90 y
TuScore=0.85: avanzaste 0.08 dentro de un intervalo de 0.13, así que obtienes
100×0.08/0.13 ≈ 61.54. Es un escenario con Max fijado, no una reconstrucción
de Restroom Icon Matching. Conocer el resultado del Comité no basta para
conocer Max: también interviene el mejor envío.
La unidad de comparación incluye el conjunto de datos
Un split es una partición de los ejemplos. Aunque uses la misma métrica, medir sobre otros ejemplos puede dar otro resultado. Los extremos de una escala oficial pertenecen a una edición y a un split concreto; no convierten cualquier score obtenido con una validación propia en puntos oficiales.
| Conjunto o evaluación | Qué información aporta |
|---|---|
| Entrenamiento | Ejemplos con los que ajustas modelo y preprocesamiento |
| Validación local | Evidencia para comparar propuestas fuera de ese ajuste |
| Leaderboard A | Respuesta del evaluador visible durante el concurso |
| Leaderboard B | Resultado del evaluador final |
Leaderboard significa tabla de resultados. Al elegir muchas variantes por
su rendimiento en una misma muestra puedes adaptarte a sus particularidades:
es una forma de sobreajuste, aunque no hayas usado directamente sus etiquetas
en fit. El módulo 05 estudia cómo diseñar esa evaluación.
Por eso una mención de «0.85» necesita contexto: métrica, datos y procedimiento. Protocolo de simulacro distingue puntajes brutos, estimaciones y comparaciones históricas que sí usan condiciones equivalentes.
Más puntos por unidad bruta no significa una mejora más fácil
Con extremos fijos, una mejora delta aporta 100×delta/(Max−Baseline).
Si delta=0.01, un intervalo de 0.13 aporta 7.69 puntos y uno de 0.52 aporta
1.92. El intervalo pequeño amplifica la misma mejora. No informa si esa
mejora requiere corregir un archivo, probar un modelo o investigar durante horas.
Los resultados históricos aportan otra clase de evidencia. En la cohorte 2025, Restroom Icon Matching tuvo media 3.98/100 y 86% de ceros entre 284 concursantes; Antique Painting Authentication, media 47.73 y cerca de 1% de ceros. Eso describe lo observado en esa edición. Un cero no revela si hubo un intento, un fallo de ejecución o un resultado sin mejora, ni convierte la media en una medida universal de dificultad.
Elegir entre experimentos con incertidumbre
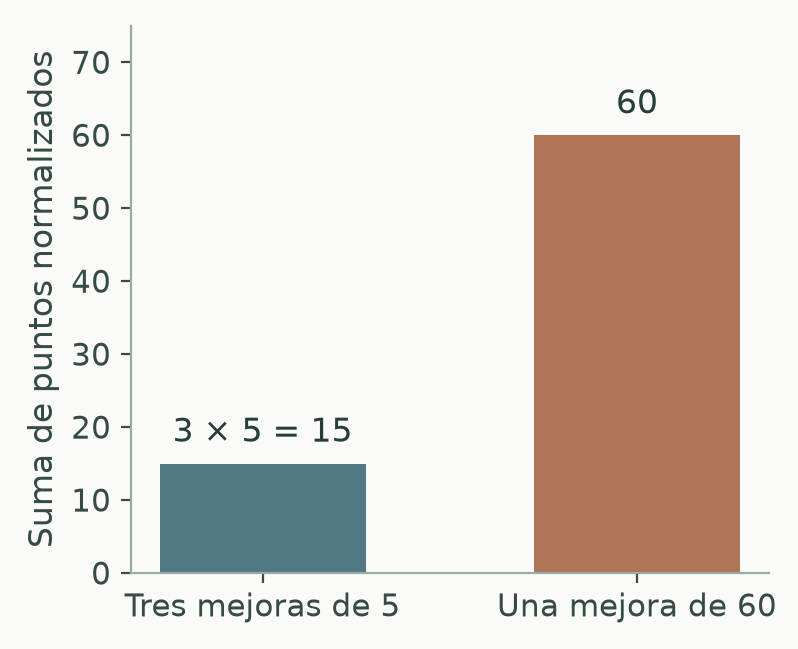
Explorar las tareas y comprobar que puedes producir una salida válida reduce el riesgo de descubrir tarde un problema de preparación. Después interesa comparar ganancia esperada, coste e incertidumbre de ideas concretas. Tres mejoras de 5 puntos suman 15; una de 60 suma 60. Repartir esfuerzos puede reducir el riesgo de depender de una sola idea, pero no garantiza más puntos.
Imagina dos experimentos: A costaría 30 minutos y daría 6 puntos; B costaría
60 minutos y daría 9. Si ambas mejoras fueran seguras, A tendría mayor ganancia
por minuto. Si A solo funcionara la mitad de las veces y al fallar no ganara
nada, su ganancia esperada sería 3 puntos: 0.5×6 + 0.5×0. La decisión cambia
al considerar esa incertidumbre. Son estimaciones para pensar, no promesas del
rendimiento de una técnica.
Los cortes históricos también dependen de las tareas y participantes de cada edición. El bronce 2026 empezó en 42.83/600 en ese ranking; ese dato no define qué se necesita aprender ni cuál será el corte de 2027.
El modelo es una parte de la entrega
El contrato de una tarea especifica entradas, salida esperada, recursos permitidos y cómo se reejecuta o evalúa la solución. Un buen predictor solo ayuda si su salida satisface ese contrato. El cuaderno 02 ya muestra un caso pequeño: conservar el orden entre IDs y predicciones.
En tareas reales el formato cambia. Muchas de 2026 reejecutan
solution.ipynb; IOAI Field exige además custom_model.py;
Potato recibe decisiones durante una interacción. Sus fichas explican
esas diferencias. No necesitas preparar ahora todos esos entornos: aquí
interesa reconocer que «entrené un modelo» y «tengo una entrega válida» no
son la misma afirmación. Los permisos de datos y modelos dependen del contrato,
no del nombre de una carpeta ni de que un archivo esté en caché.
Para poner a prueba la intuición
Con Baseline=20, Comité=80 y mejor envío bruto 90, ¿qué puntos recibe una
solución de 55? Max es 90 y el avance es 35/70: 50 puntos. ¿Qué cambia si
el mejor envío fuera 70? Ahora Max es 72; puedes comparar ambas escalas sin
cambiar de modelo.
En el ejemplo de los experimentos A y B, ¿qué pasaría si dispusieras solo de 40 minutos, o si fallar A dejara una idea útil para B? El cociente puntos/minuto es una ayuda, no una descripción completa de todas las decisiones.
Más adelante, 18 - Texto y 24 - Entrenar con tareas IOAI llevan estas ideas a Ghost of the Machine y otras tareas oficiales. Los números de sus fichas necesitan el contexto de su propio evaluador. El siguiente módulo vuelve a la capa anterior a la normalización: qué errores decide premiar o castigar la métrica.
← 02 - Tu primer modelo · Ruta de Aprendizaje · Probabilidad y logaritmos para aprender →