02 · Tu primer modelo
Nivel 1 — El piso · Ruta de Aprendizaje
Hasta ahora escribías la regla que transforma entradas en salidas. En aprendizaje supervisado, proporcionas ejemplos de ambas y un procedimiento ajusta una regla a partir de ellos. Esa regla ajustada es el modelo. La pregunta interesante es si sirve también para ejemplos nuevos, no solo para los que participaron en su ajuste.
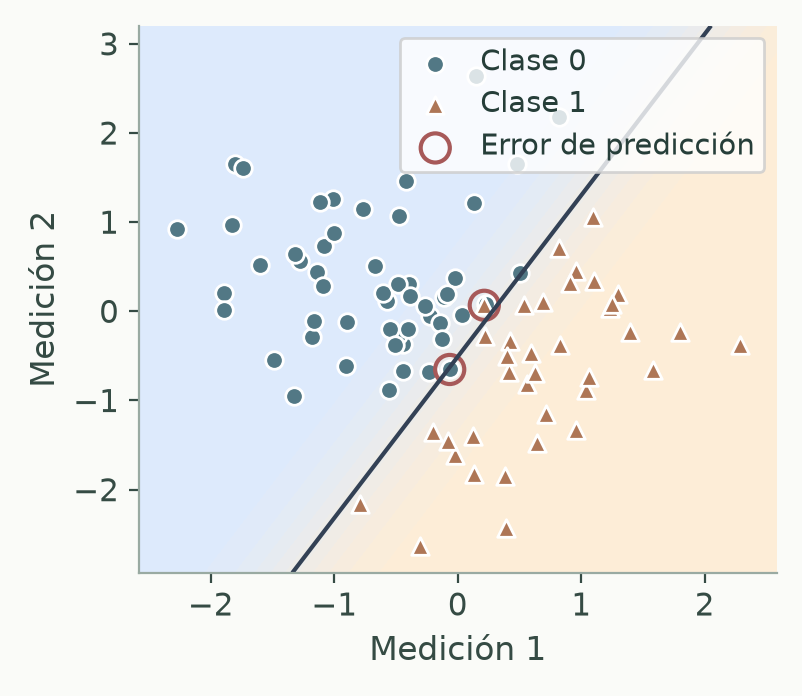
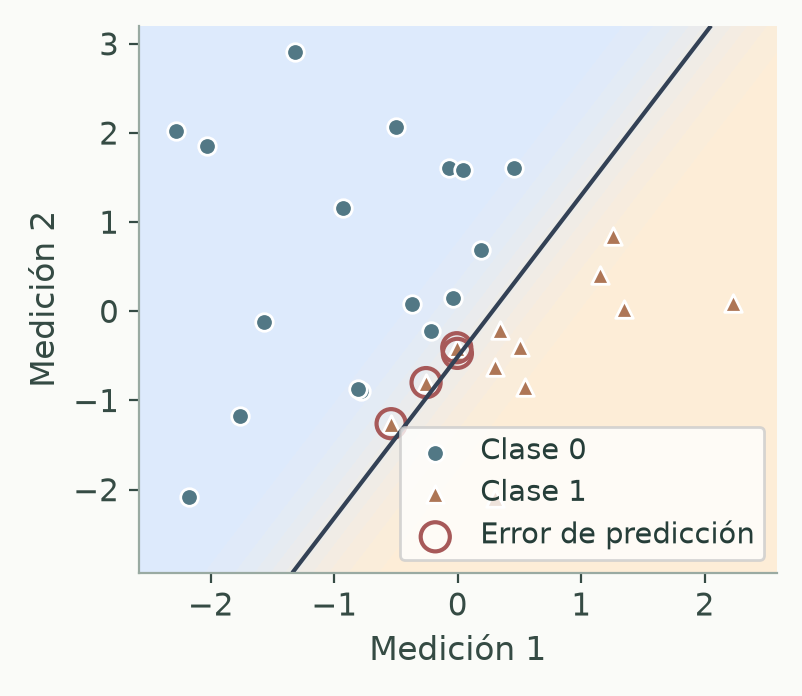
Mismos datos y modelo del ejemplo del módulo 02; la línea marca probabilidad 0,5. El modelo se ajusta solo con entrenamiento y se aplica sin cambios a validación.
Los colores son las clases conocidas. La frontera es la regla que aprendió el modelo con los puntos de entrenamiento; después la aplicamos a validación. Un punto del lado equivocado es un error de predicción. Cambiar la frontera puede corregir algunos errores y crear otros.
Un ejemplo que se puede ejecutar completo
Qué significa aprender de datos construyó una regresión con tres filas.
Ahora reuniremos preparación, ajuste y evaluación. Conservamos la separación
entre fit, que aprende estado, y predict, que lo aplica.
Usaremos scikit-learn, una biblioteca con modelos que comparten una interfaz.
Este ejemplo fabrica 120 piezas ficticias con dos mediciones cada una. X
guarda las mediciones y y, la clase de la misma fila: 0 o 1. La etiqueta se
genera con una relación sencilla y algo de ruido; el modelo solo recibe los
ejemplos, no esa fórmula.
Separamos dos conjuntos: entrenamiento para ajustar y validación para observar qué ocurre en filas que no participaron en el ajuste. El baseline mayoritario ofrece una comparación: ¿cuánto acertaría sin mirar las mediciones?
import numpy as np
from sklearn.model_selection import train_test_split
from sklearn.dummy import DummyClassifier
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score

rng = np.random.default_rng(17)
X = rng.normal(size=(120, 2))
y = (1.2 * X[:, 0] - 0.8 * X[:, 1] + rng.normal(0, 0.2, 120) > 0.3).astype(int)
X_train, X_val, y_train, y_val = train_test_split(
    X, y, test_size=0.25, random_state=17, stratify=y,
)

baseline = DummyClassifier(strategy="most_frequent")
baseline.fit(X_train, y_train)

modelo = make_pipeline(StandardScaler(), LogisticRegression(max_iter=1000))
modelo.fit(X_train, y_train)
pred = modelo.predict(X_val)

print("formas:", X_train.shape, X_val.shape)  # (90, 2), (30, 2)
print("baseline:", accuracy_score(y_val, baseline.predict(X_val)))
print("modelo:  ", accuracy_score(y_val, pred))
test_size=0.25 reserva una cuarta parte. Aquí la llamamos validación por el
uso que le damos; el nombre del argumento no convierte esas filas en un test
final. stratify=y procura conservar proporciones de clases. El módulo 05
explica cuándo ese reparto responde bien la pregunta de predicción.
La regresión logística aprende una frontera recta en este plano. Por
ahora basta con observar qué separa; el módulo 06 abrirá su fórmula.
StandardScaler estandariza cada variable con las estadísticas de entrenamiento,
como en el módulo 00. make_pipeline compone ambas operaciones para aplicarlas
en el mismo orden al ajustar y al predecir.
Leer la construcción de los datos y del pipeline
rng.normal(size=(120,2)) fabrica una tabla de números aleatorios con esa
forma. X[:,0] y X[:,1] seleccionan sus columnas: en la regla sintética
multiplicamos una por 1.2, restamos 0.8 veces la otra y añadimos ruido.
Comparar con 0.3 produce booleanos; .astype(int) los convierte en 0 y 1.
Estos son datos inventados para observar un mecanismo, no mediciones reales.
train_test_split divide X e y con los mismos índices, conservando sus
parejas. Sus cuatro resultados se asignan en el orden que muestra el código.
random_state fija el azar del reparto para poder repetirlo; stratify=y
usa las clases para procurar mantener sus proporciones.
Un pipeline es una secuencia de pasos. Al llamar fit, el escalador
aprende estadísticas de train y transforma esas entradas; después la logística
aprende con el resultado. En predict, el escalador usa sus estadísticas
guardadas y la logística sus pesos guardados. Un pipeline organiza el proceso,
pero no decide qué datos está permitido entregarle.
Qué hace un baseline y qué no demuestra
Un baseline es una referencia reproducible. DummyClassifier aprende qué
clase es más frecuente en entrenamiento y la repite para cada fila nueva. No
esperamos que sea sofisticado: permite saber cuánto aporta usar las variables.
La receta Baseline trivial muestra también su implementación.
Si el baseline logra 0.70 y otra propuesta 0.71, existe una mejora observada, pero falta saber si se sostiene con más ejemplos o particiones. Si hay 98% de una clase, predecir siempre esa clase ya da accuracy 0.98: ese valor no acredita que el modelo reconozca la clase escasa. 04 - Métricas examina qué otras preguntas podemos hacer a esas mismas predicciones.
En una tarea IOAI hay además un baseline oficial: una solución de referencia con un score que interviene en la normalización. Puede ser más elaborado que el mayoritario. Tu baseline local y su resultado oficial no son intercambiables; 03 - La competencia y la estrategia explica la diferencia.
Ajustar, transformar y predecir
Los bloques siguientes continúan con las variables del ejemplo anterior:
pred = modelo.predict(X_val)            # una etiqueta por fila: forma (30,)
probs = modelo.predict_proba(X_val)      # una estimación por clase: forma (30, 2)
print(modelo.classes_)                  # [0, 1]: orden de las columnas de probs
fit ajusta el modelo usando ejemplos. predict aplica lo aprendido a las
entradas recibidas. Algunos clasificadores ofrecen predict_proba, pero no
hay que suponerlo para todos: ni que sus estimaciones estén bien calibradas,
como veremos en el módulo 04.
Un transformador cambia la representación de las entradas. En el escalador,
fit aprende medias y desviaciones; transform las aplica sin recalcularlas:
escalador = StandardScaler()
escalador.fit(X_train)
val_escalada = escalador.transform(X_val)
print(val_escalada.shape)               # (30, 2): conserva ejemplos y variables
Un valor de validación situado diez unidades sobre la media de entrenamiento se transforma respecto de esa media, no respecto de una media nueva de validación. Si cada conjunto se centrara a su manera, cambiaría el significado de las coordenadas que recibe el modelo. Estandarizar sin fuga desarrolla por qué tampoco se aprende el escalador con ambos conjuntos juntos.
El pipeline automatiza esa composición; no decide por ti qué filas puedes
usar. Si le das todo a fit, ajustará todo. En 05 - Validación honesta,
la validación cruzada repetirá el ajuste en varios repartos, con un escalador
propio para cada entrenamiento. k-NN con escalado muestra otra aplicación.
Del modelo a una salida utilizable
Una predicción también necesita conservar a qué ejemplo pertenece. Para tres piezas nuevas, el mismo orden de filas conecta IDs y predicciones:
import pandas as pd

nuevas = pd.DataFrame({
    "id": ["pieza-C", "pieza-A", "pieza-B"],
    "medida_1": [1.0, -1.0, 0.2],
    "medida_2": [0.0, 1.0, -0.5],
})
pred_nuevas = modelo.predict(nuevas[["medida_1", "medida_2"]].to_numpy())
salida = pd.DataFrame({"id": nuevas.id, "clase": pred_nuevas})
print(salida.to_csv(index=False))
Ese texto tiene formato CSV. El cuaderno 02 · Clasificador completo de Laboratorios guiados lo guarda en un archivo y comprueba sus filas. El ID sirve para relacionar entradas y salidas; no lo usamos como medición de la pieza. Ordenar solo los IDs o solo las predicciones rompería esa relación. Cada tarea oficial especifica su propio formato, que puede ser distinto.
Elegir una primera hipótesis
La logística de este ejemplo es rápida y permite ver una frontera sencilla. Si la relación fuera curva, un vecino cercano, un árbol o un modelo con otra representación podrían ajustarla mejor. Los capítulos 06 y 07 comparan esas posibilidades; no hay una familia que gane por tener más parámetros o por llamarse boosting.
Con pocos ejemplos, un modelo flexible puede seguir detalles accidentales. Una red grande entrenada desde cero añade decisiones y coste, pero tampoco pierde automáticamente contra un bosque. La evidencia útil es una comparación con el mismo conjunto, métrica y presupuesto. Imágenes, texto y audio requieren además decidir cómo representar sus entradas, tema de niveles posteriores.
Una mejora aparente puede venir de cambiar las filas de validación en vez del modelo. Y una fuga de información —por ejemplo, elegir variables mirando respuestas que debían quedar reservadas— puede contaminar la comparación sin un síntoma infalible en el score. No basta con que el número parezca plausible.
Un experimento para mirar
El cuaderno 02 dibuja la frontera y rodea sus errores. ¿Qué ocurre si mueves un punto a través de ella? ¿Cambia de golpe la etiqueta, y qué pasa con su probabilidad estimada? Multiplica una variable por cien y compara con y sin escalado, manteniendo el mismo reparto de filas.
Intro to Machine Learning de Kaggle es apoyo opcional en inglés. Antique Painting Authentication permite trasladar el ciclo a datos oficiales más adelante, con su preparación y su propio evaluador. Su score publicado no es una escala para nuestro ejemplo.
Ya tenemos una predicción y una medida. Antes de buscar un número mayor, conviene distinguir qué mide ese número y cómo lo convierte en puntos una competencia.
← Qué significa aprender de datos · Ruta de Aprendizaje · 03 - La competencia y la estrategia →