20 · Modelos generativos
Nivel 3 — Las modalidades · Ruta de Aprendizaje
Antes de empezar. Capas y pérdidas del módulo 10 y la diferencia entre congelar pesos y cortar gradientes del 14. Empezaremos con un autoencoder ejecutable sobre puntos y seguiremos un paso de una GAN. VAE y difusión sirven después como mapa conceptual; sus implementaciones completas son ampliaciones.
Si una red puede reconstruir una imagen, ¿también puede inventar una nueva? No necesariamente: reconstruir empieza con un ejemplo; generar necesita una forma de elegir de dónde partir. El espacio latente es una representación interna desde la que un decoder produce datos. Cómo se aprende y cómo se muestrea ese espacio distingue varias familias generativas.
Los encoders de los módulos anteriores resumían entradas para decidir algo. Ahora nos interesa también el recorrido hacia una imagen, una onda o una pista.
El cuaderno 08 · Visión de Laboratorios guiados entrena una GAN pequeña sobre puntos 2D: puedes observar diversidad y colapso sin descargar modelos.
La forma de tarea, y en qué se distingue
Un modelo generativo aprende a producir muestras, a veces condicionadas a un texto u otra entrada. Puede haber muchas respuestas válidas. Evaluar puede incluir datos de referencia, propiedades estadísticas, personas o modelos; «generativo» no significa necesariamente «juzgado por otra IA».
Estas tareas IOAI sí incorporaron modelos en la evaluación:
| Tarea | Qué pedía | Quién juzgaba |
|---|---|---|
| Lost in Translation (2024) | que un texto-a-imagen intercambiara «zebra» y «giraffe» | un detector de objetos |
| The Madarian Cow Mystery (2024) | que agregara un hidrante sin perder la vaca | un detector de objetos |
| Concepts (2025) | producir una secuencia de íconos como pista | otra IA adivinando |
Una imagen que parece mejor puede puntuar peor frente a ese evaluador. La métrica y la inspección visual aportan evidencias diferentes: una mide el criterio de la prueba; la otra puede revelar artefactos que el criterio omite. Cuando el evaluador oficial está disponible, permite observar esa diferencia.
Autoencoders: comprimir para reconstruir
Un autoencoder aprende a comprimir su entrada y reconstruirla. Usemos tres
puntos: (−1,−2), (0,0) y (1,2). Dos coordenadas bastan para escribirlos,
pero están sobre una recta: podríamos guardar solo una y recuperar la otra.
El encoder reduce dos coordenadas a una; el decoder vuelve de una a dos.
Inicialmente el encoder calcula (x1+x2)/2 y el decoder repite ese número.
Así, (1,2) se convierte en 1.5 y vuelve como (1.5,1.5): aún no reconstruye
bien. Entrenaremos ambos para reducir ese error. El objetivo es la propia
entrada; no hacen falta etiquetas de clase.
# bloque: probado; id: autoencoder_local
import torch
import torch.nn as nn

datos = torch.tensor([[-1., -2.], [0., 0.], [1., 2.]])
encoder = nn.Linear(2, 1, bias=False)
decoder = nn.Linear(1, 2, bias=False)
with torch.no_grad():
    encoder.weight.fill_(0.5)
    decoder.weight.fill_(1.)
autoencoder = nn.Sequential(encoder, decoder)
opt = torch.optim.SGD(autoencoder.parameters(), lr=0.05)
with torch.no_grad():
    reconstruccion_inicial = autoencoder(datos).clone()
    error_inicial = ((reconstruccion_inicial - datos) ** 2).mean().item()
for _ in range(200):
    reconstruida = autoencoder(datos)
    error = ((reconstruida - datos) ** 2).mean()
    opt.zero_grad()
    error.backward()
    opt.step()
with torch.no_grad():
    reconstruccion_final = autoencoder(datos)
    error_final = ((reconstruccion_final - datos) ** 2).mean().item()
print(reconstruccion_inicial)  # [-1.5,-1.5], [0,0], [1.5,1.5]
print(reconstruccion_final)    # se aproxima a los tres puntos originales
print(error_inicial, error_final)
MSE promedia aquí seis coordenadas, por eso el error inicial es 1/6. La composición de estas dos capas sigue siendo lineal: basta para esta recta, no para cualquier nube. Para imágenes se pueden usar capas no lineales y cuellos mayores; el laboratorio y las aplicaciones finales amplían esa idea.
El cuello limita la representación, pero no garantiza que conserve lo «esencial» para otra tarea. Puede memorizar regularidades poco útiles. El error de reconstrucción sirve como señal candidata de anomalía, como con PCA, pero algunas anomalías también se reconstruyen bien.
Del autoencoder al VAE: de dónde sale una muestra nueva
Un autoencoder ordinario no obliga a que sus códigos ocupen una distribución fácil de muestrear. Elegir un vector normal al azar puede llevar al decoder a una región que nunca aprendió a usar.
Un autoencoder variacional (VAE) agrega un encoder probabilístico. En el caso gaussiano, produce media
μ y desviación σ, y muestrea z = μ + σ·ε, con ε normal estándar.
Por ejemplo, μ=2, σ=0.5, ε=−1 dan z=1.5.
El prior es la distribución elegida como punto de partida para generar, por ejemplo una normal estándar. El entrenamiento relaciona los códigos del encoder con esa distribución para que muestrear de ella resulte útil.
| Operación | De dónde sale z | Qué hace el decoder |
|---|---|---|
| Reconstruir con AE | encoder de la entrada | reconstruye esa entrada |
| Reconstruir con VAE | distribución del encoder para esa entrada | intenta reconstruirla desde una muestra |
| Generar con VAE | prior, por ejemplo normal estándar | produce una muestra sin imagen inicial |
El objetivo combina reconstrucción y divergencia KL, que penaliza alejar la distribución del encoder del prior. Equilibra fidelidad y organización del espacio; no garantiza muestras perfectas. Es un puente conceptual hacia generar, no un requisito adicional de implementación del syllabus. Auto-Encoding Variational Bayes.
GANs: el generador contra el crítico
Un generador G transforma ruido latente en muestras y un discriminador D intenta distinguir muestras reales de generadas. G aprende a producir muestras que D confunda con reales. Como el rival cambia durante el entrenamiento, una pérdida menor no implica que ambas redes estén mejorando de manera estable. Formulación de GAN.
En el laboratorio 08, los datos reales forman varias nubes de puntos. Cada nube es un modo: una región de alta concentración. Si G produce solo una nube convincente, puede engañar a D en algunos ejemplos mientras pierde diversidad. Eso hace visible el colapso de modos sin entrenar imágenes grandes.
Los dos pasos alternados aclaran el recorrido del gradiente:
| Paso | Datos que recibe D | Qué parámetros cambian |
|---|---|---|
| Aprender a distinguir | reales y G(z).detach() | los de D |
| Aprender a generar | G(z) sin cortar el gradiente | los de G |
En el segundo paso, los pesos de D permanecen fijos, pero su derivada respecto de la entrada deja llegar el gradiente a G. Congelar pesos y cortar el grafo son operaciones diferentes. Observar los mismos latentes antes y después permite ver cómo se mueve la distribución, sin confundir ese cambio con otro sorteo de ruido.
Un detector de voz sintética como Synthetic Speech Detector no es por eso el discriminador de una GAN: puede ser un clasificador supervisado independiente.
Seguir una ronda antes de entrenar muchas
Tomemos los cuatro centros del experimento 2D del laboratorio, sin su ruido para esta primera ronda. D devuelve un logit por punto: la pérdida binaria del módulo 10 compara esos logits con 1 para reales y 0 para generados. Este bloque construye las dos redes del experimento y da un paso de D:
# bloque: probado; id: gan_paso_d
import torch
from torch import nn
import torch.nn.functional as F

torch.manual_seed(41)
G = nn.Sequential(nn.Linear(2, 32), nn.Tanh(), nn.Linear(32, 32), nn.Tanh(), nn.Linear(32, 2))
D = nn.Sequential(nn.Linear(2, 32), nn.LeakyReLU(.2), nn.Linear(32, 32), nn.LeakyReLU(.2), nn.Linear(32, 1))
opt_g = torch.optim.Adam(G.parameters(), lr=.001, betas=(.5, .999))
opt_d = torch.optim.Adam(D.parameters(), lr=.001, betas=(.5, .999))
reales = torch.tensor([[-1., -1.], [-1., 1.], [1., -1.], [1., 1.]])
z = torch.randn(4, 2)
with torch.no_grad():
    puntos_antes = G(z).clone()
falsos = G(z).detach()
loss_d = F.binary_cross_entropy_with_logits(D(reales), torch.ones(4, 1))
loss_d = loss_d + F.binary_cross_entropy_with_logits(D(falsos), torch.zeros(4, 1))
opt_d.zero_grad()
loss_d.backward()
opt_d.step()
detach() conserva las coordenadas falsas, pero corta su conexión con G.
D aprende a distinguirlas; G no recibe ese gradiente. Para mover G hacemos
un forward nuevo, con el D que acaba de cambiar:
# bloque: probado; id: gan_paso_g
# Continúa con las redes, optimizadores y z del bloque anterior.
for parametro in D.parameters():
    parametro.requires_grad_(False)
loss_g = F.binary_cross_entropy_with_logits(D(G(z)), torch.ones(4, 1))
opt_g.zero_grad()
loss_g.backward()
opt_g.step()
with torch.no_grad():
    puntos_despues = G(z).clone()
print(puntos_antes)
print(puntos_despues)
for parametro in D.parameters():
    parametro.requires_grad_(True)   # preparar el siguiente paso de D
El objetivo 1 pide que D considere reales los puntos generados. Sus pesos
están congelados durante este paso, pero sus operaciones siguen conectando
la pérdida con G. Usar no_grad() alrededor de D(G(z)) cortaría también
ese camino. Comparar el mismo z antes y después revela un movimiento causado
por el ajuste; una sola ronda no demuestra que G cubra los cuatro grupos.
El cuaderno 08 · Visión repite esta alternancia, agrega ruido a los centros
y dibuja muchas muestras. Es la continuación del mismo mecanismo. Para comprobar
la intuición, predice qué red dejaría de aprender si pusieras .detach() también
en el segundo paso: sería G, porque ya no llegaría hasta sus pesos la pérdida.
Difusión: aprender con ruido que sí conocemos
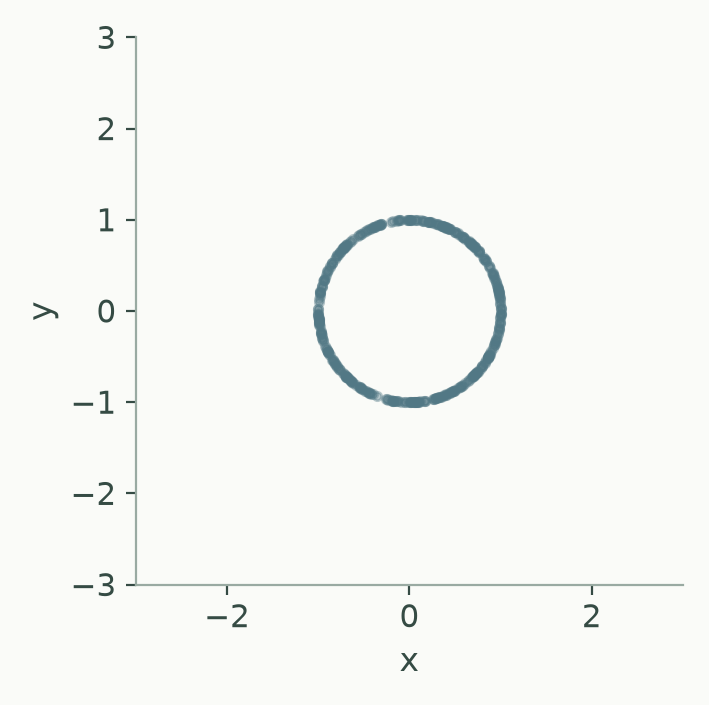
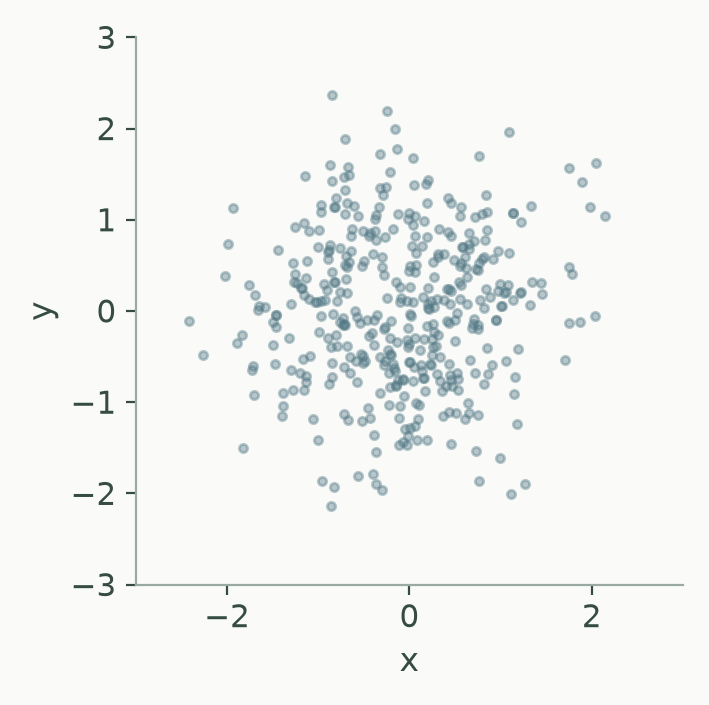
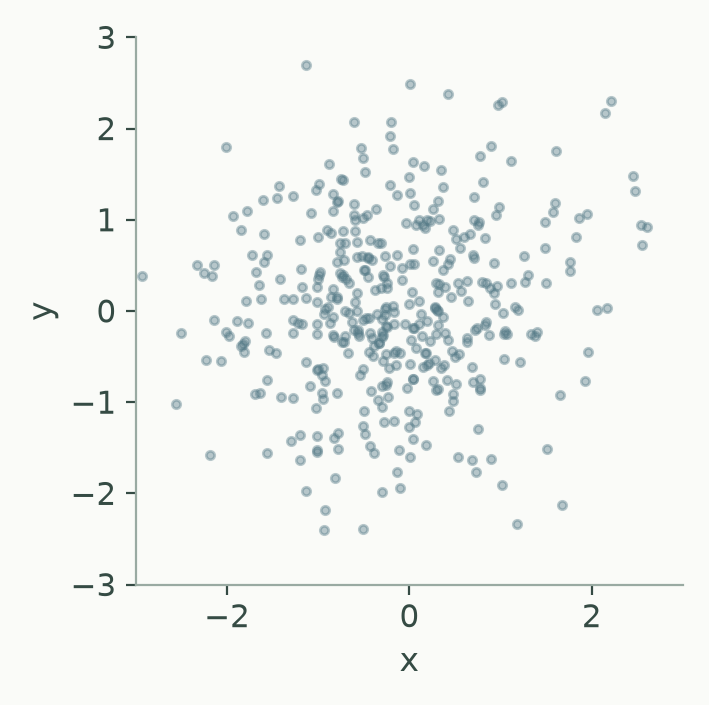
Proceso directo calculado sobre datos sintéticos. No muestra un generador entrenado.
En el primer panel se ve el círculo limpio. Con el coeficiente acumulado 0.6, el ruido dispersa sus puntos; con 0.05, la estructura es difícil de reconocer. El proceso directo mezcla señal y ruido con coeficientes conocidos. El problema de aprendizaje aparece al intentar recuperar estructura en el sentido contrario. Estas nubes muestran el proceso directo, no muestras de un generador entrenado.
La figura muestra el proceso directo. En una formulación DDPM,
una entrada limpia x₀ se mezcla con ruido normal ε:
x_t = sqrt(a_t) · x₀ + sqrt(1 − a_t) · ε
a_t es la fracción de señal acumulada, cercana a uno al principio y pequeña
al final. Durante entrenamiento elegimos t y ε: conocemos exactamente el
ruido objetivo. Una red recibe x_t y t, y aprende a predecir ε mediante
error cuadrático.
Al generar no conocemos una imagen original ni su ruido. Partimos de ruido y usamos las predicciones dentro de una regla de muestreo que recorre niveles decrecientes; puede añadir aleatoriedad en pasos intermedios. No es restar un ruido original conocido ni recuperar necesariamente una imagen del entrenamiento. DDPM: entrenamiento y muestreo.
En difusión latente, ese proceso opera sobre códigos de un autoencoder; un decoder los convierte luego en imagen. El texto puede condicionar la red mediante atención cruzada, conectando con el módulo 13. Condicionar orienta la generación, sin garantizar que respete todo el prompt. Latent Diffusion Models.
Los pasos de inferencia y la escala de guía dependen del modelo y su muestreador. Más pasos cuestan más evaluaciones, pero no mejoran necesariamente la calidad. La guía combina predicciones condicionadas y no condicionadas y modifica el compromiso entre fidelidad y diversidad; «más» no equivale a «mejor». Classifier-Free Guidance. SD-Turbo, por ejemplo, está preparado para pocos pasos y su ficha desactiva esa guía: copiarle parámetros de otro pipeline cambiaría el método. Ficha de SD-Turbo.
Intervenir un generador: las tres vías
Las tareas de 2024 no pedían usar un modelo texto-a-imagen: pedían modificarlo para que asociara conceptos distintos. Las vías, de menos a más invasiva:
1. El prompt. Cambiar el condicionamiento puede ser barato, si la tarea lo permite. Cuando el enunciado exige mantener «zebra» y cambiar lo generado, reemplazar esa palabra por «giraffe» no resuelve la intervención pedida.
2. Fine-tuning con LoRA (módulo 14). Adaptar parte del modelo con pares imagen-texto que expresen la asociación deseada. Los datos sintéticos son una posibilidad cuando están permitidos; su calidad limita lo que puede aprenderse.
3. Editar pesos directamente. Intervenir parámetros asociados al comportamiento buscado. Una asociación puede estar distribuida: cambiarla puede afectar también otros conceptos, aunque el parche de pesos sea pequeño.
Y el detalle que decide el puntaje: The Madarian Cow Mystery pedía agregar el hidrante sin perder la vaca. Es el olvido catastrófico del módulo 14, en versión generativa: la métrica exigía las dos cosas, así que había que medir las dos en cada experimento.
Generar bajo restricción de formato
Concepts (2025) es el caso más interesante porque lo que se genera no es texto libre: es una secuencia ordenada de íconos de un conjunto fijo. Y el enunciado del at-home Chameleon ya avisaba que el orden importa: el primer ícono es la idea central y los siguientes la matizan.
La estructura de trabajo que esas tareas piden:
tu generador ──► candidato ──► el evaluador (LLM / adivinador) ──► puntaje
      ▲                                                             │
      └─────────────────── iterar con ese puntaje ───────────────────┘
Cada evaluación tiene un costo. Un proxy es un evaluador sustituto: puede ayudar a explorar si es más barato o accesible, pero también puede ordenar los candidatos de forma distinta al oficial. Optimizarlo repetidamente aumenta el riesgo de explotar sus peculiaridades. Su utilidad depende de que conserve las distinciones relevantes; no es un paso obligatorio de toda tarea generativa.
⚠️ Las tres trampas
1. Confundir apariencia y score. La inspección visual ayuda a encontrar fallos, pero no sustituye al criterio que puntúa. A la inversa, un score alto puede ocultar artefactos que el evaluador no reconoce.
2. Optimizar una mitad de la métrica. Cuando la métrica pide dos cosas —el hidrante y la vaca; aprender lo nuevo y recordar lo viejo— hay que medir las dos en cada iteración, o mejoras una destruyendo la otra sin notarlo.
3. Confundir optimizar el proxy con resolver la tarea. Su costo y su fidelidad importan. Un sustituto rápido que elige los candidatos equivocados puede empeorar la solución.
🏋️ Práctica
Primero, reconstruir un punto nuevo
Después de entrenar el autoencoder, prueba (0.5,1) y (1,−0.5). El primero
sigue la recta del entrenamiento; el segundo está fuera. Compara sus errores
y dibuja los puntos reconstruidos. ¿Qué significa un error grande en este caso?
Para contrastar
La reconstrucción de
(0.5,1)debe ser cercana al original. Todas las salidas del decoder lineal viven sobre una recta; el segundo punto no puede recuperarse exactamente en la recta aprendida. Eso indica una limitación de representación, no demuestra que el punto sea un dato inválido ni una anomalía de una tarea real.
Para profundizar
| # | Ejercicio | Fuente | Qué practica |
|---|---|---|---|
| 1 | HuggingFace Diffusion Course, capítulos 1-2 | huggingface.co/learn | difusión, guiada |
| 2 | Autoencoder en MNIST: reconstruye y detecta anomalías por error | — | el punto de entrada del syllabus |
| 3 | ⭐⭐ Lost in Translation: intercambiar zebra y giraffe, evaluado por detector | .zip oficial | la tarea generativa central |
| 4 | ⭐ The Madarian Cow Mystery: agregar el hidrante sin perder la vaca | repo oficial | métrica de dos partes |
| 5 | ⭐ Concepts: escríbete un adivinador local y optimiza contra él | repo oficial | el patrón proxy/evaluador |
| 6 | Hogspell: dirigir un modelo de difusión | NEOAI 2025 | intervención, problema nacional |
Las soluciones de 2024 publicadas en los archivos Best-solutions permiten
contrastar enfoques. Busca qué comportamiento cambian y cómo evitan perder lo
que debía permanecer: el mecanismo importa más que copiar hiperparámetros.
🎯 Mini-desafío (formato IOAI)
Tarea: Concepts (IOAI 2025, día 1). Métrica: proporción de secretos que el adivinador oficial acierta. Baseline: 0.20. Techo del Comité: 0.54.
Son referencias históricas, no un techo universal ni una explicación causal de la media 19.1/100 del Individual 2025 (284 concursantes). El score de tu proxy local tiene su propio baseline; no equivale al evaluador oficial.
Una hipótesis es que íconos cercanos al secreto por coseno producen buenas pistas. Otra es que una combinación de íconos menos obvios elimina mejor las alternativas. Explora casos donde discrepan: ¿el adivinador entiende cada ícono por separado, su orden o su relación? Si usas un proxy, esa pregunta también permite estudiar dónde deja de parecerse al evaluador oficial.
Para poner a prueba la intuición
¿Puede mejorar la pérdida del generador mientras empeora la diversidad de sus muestras?
Compara los mismos latentes antes y después de entrenar: ¿qué aprendió el generador?
Si tu evaluador local mejora y el oficial empeora, ¿qué hipótesis investigarías?
← 19 - Audio y señales · Ruta de Aprendizaje · 21 - Adversarial y robustez →