14 · Fine-tuning y LoRA
Nivel 2 — Deep learning · Ruta de Aprendizaje
Un encoder congelado puede distinguir temas generales y aun así ignorar la diferencia que necesitamos predecir. ¿Cuánto de su representación conviene cambiar? Fine-tuning significa continuar el entrenamiento de un modelo preentrenado para adaptarlo. Podemos mover todos sus pesos, una parte, o añadir parámetros nuevos que modifiquen su respuesta.
Las cuatro opciones, y cuándo cada una
| Opción | Qué se entrena | Compromiso |
|---|---|---|
| Encoder congelado | una cabeza o modelo posterior; nada del encoder | permite reutilizar features, pero no adapta su representación |
| Fine-tuning parcial | cabeza y algunas capas del encoder | adapta parte de la representación y limita los pesos que cambian |
| Fine-tuning completo | todo el modelo | permite cambios amplios y necesita gradientes y estados para todos los pesos |
| LoRA | adaptadores y la cabeza nueva, si la hay | restringe la forma de la actualización y reduce parámetros entrenables |
Una cabeza transforma la representación en la salida de nuestra tarea: por ejemplo, dos logits para una clasificación binaria. No es una cabeza de atención: aquí la palabra nombra el módulo de salida.
Empezar por un encoder fijo permite medir qué consigue su representación sin adaptarla. La comparación con otras opciones depende de validación, datos, memoria y tiempo; no hay un tamaño de modelo que decida por sí solo la respuesta.
Fine-tuning completo: un encoder + una cabeza
Cómo leer la clase del modelo
class Clasificador(torch.nn.Module) declara un modelo usando la clase
base de PyTorch. __init__ prepara lo que debe recordar; super().__init__()
inicializa los mecanismos de esa base. Al asignar un módulo a
self.encoder o self.cabeza, PyTorch registra sus parámetros como
partes del modelo. Por eso aparecen después en modelo.parameters().
forward describe el cálculo con una entrada. Al llamar
modelo(ids, mascara), PyTorch invoca ese cálculo a través de su mecanismo
de llamada. Crear el objeto no lo entrena: hacen falta pérdida, backward y
optimizador. last_hidden_state es un campo de la salida del encoder;
seleccionarlo extrae el tensor que necesitamos, no crea otra capa.
Seguir las formas
En el ejemplo, ids y mascara tienen forma (lote, tokens). El encoder
produce (lote, tokens, ancho); el pooling enmascarado del módulo 12 lo reduce
a (lote, ancho); una capa lineal devuelve (lote, n_clases). Esa salida son
los logits que recibe la pérdida del módulo 10.
# bloque: probado; id: clasificador_texto
import torch

class Clasificador(torch.nn.Module):
    def __init__(self, encoder, n_clases):
        super().__init__()
        self.encoder = encoder
        self.cabeza = torch.nn.Linear(encoder.config.hidden_size, n_clases)

    def forward(self, ids, mascara):
        h = self.encoder(input_ids=ids, attention_mask=mascara).last_hidden_state
        m = mascara.unsqueeze(-1)
        vector = (h * m).sum(1) / m.sum(1).clamp(min=1)     # mean pooling enmascarado
        return self.cabeza(vector)                          # logits, sin softmax
Después de preparar el modelo permitido en disco, crea una instancia nueva para cada alternativa. El bloque anterior se prueba con un BERT diminuto de pesos aleatorios, construido localmente; verifica la integración, no su calidad como encoder de lenguaje.
# bloque: fragmento
from transformers import AutoModel, AutoTokenizer

RUTA = "./models/bge-base-en-v1.5"       # usa la ruta real del enunciado
tokenizador = AutoTokenizer.from_pretrained(RUTA, local_files_only=True)
encoder = AutoModel.from_pretrained(RUTA, local_files_only=True)
modelo = Clasificador(encoder, n_clases=2)
Todo lo de los módulos anteriores está ahí: el pooling enmascarado del 12, la cabeza que devuelve logits del 10, y el bucle de entrenamiento del 9.
Adaptar pesos ya útiles requiere controlar cuánto se mueven. Valores como
2e-5 a 5e-5 son escalas iniciales frecuentes para comparar en un encoder de
texto, no una regla para toda arquitectura. La cabeza nueva puede necesitar
un ritmo distinto del encoder; algunas configuraciones usan grupos de parámetros
con tasas diferentes.
Entrenamientos cortos permiten observar pronto si el ajuste ayuda. Un warmup aumenta gradualmente la tasa al inicio, en lugar de aplicar desde el primer paso la tasa máxima. Puede suavizar la adaptación de pesos y estados del optimizador; no garantiza evitar sobreajuste ni olvido. La validación determina qué cambios conviene conservar.
LoRA: reducir los parámetros que entrenas
Una capa lineal transforma un vector de entrada x mediante una matriz W.
LoRA conserva esa matriz y aprende una ruta adicional: x pasa primero por una
matriz A que lo reduce a r coordenadas, y después por B que vuelve a la
dimensión de salida. Su contribución se suma a la respuesta original.
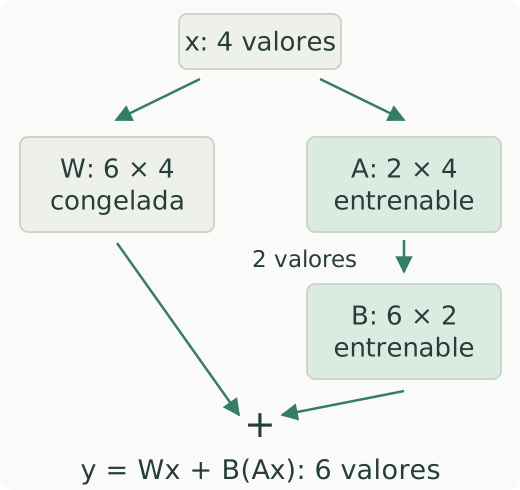
Ejemplo sin sesgo y con factor de escala 1: x tiene 4 coordenadas. A las reduce a 2 y B produce 6, compatibles con Wx. A y B suman 20 parámetros entrenables; W conserva sus 24 pesos congelados. La cabeza nueva, si la hay, también debe entrenarse.
En el dibujo, A reduce de 4 a 2 coordenadas y B produce 6: su contribución
puede sumarse a los 6 valores de Wx. El producto B·A tiene forma (6,4),
igual que W. Para una capa cuadrada de ancho d:
A: (r,d)     B: (d,r)     B·A: (d,d)
W_adaptada = W + s·B·A
Rango bajo significa que las correcciones se construyen combinando pocas
direcciones, como las r columnas de B. Restringe las actualizaciones posibles.
En LoRA estándar, s = lora_alpha/r; la figura omite esa escala para mostrar
las formas. El producto también sirve para capas no cuadradas, usando sus
dimensiones reales de entrada y salida.
Con d=768 y r=8, actualizar W requiere 589.824 parámetros entrenables;
actualizar A y B, 12.288. Es una cuenta de esa matriz, no del modelo
completo. Los pesos base siguen ocupando memoria, y las activaciones intermedias
siguen siendo necesarias para llevar el gradiente hasta los adaptadores.
Por eso las barras de la derecha conservan pesos y activaciones: ilustran
componentes, no predicen el consumo de tu GPU.
El bloque siguiente aplica LoRA al Clasificador anterior. Debe partir de una
instancia nueva si queremos compararlo con fine-tuning completo desde los mismos
pesos iniciales:
# bloque: probado; id: lora_cabeza
from peft import LoraConfig, get_peft_model

config = LoraConfig(r=8, lora_alpha=16, lora_dropout=0.05,
                    target_modules=["query", "value"],
                    modules_to_save=["cabeza"])  # la cabeza NUEVA también aprende
modelo = get_peft_model(modelo, config)
modelo.print_trainable_parameters()      # la proporción depende de la arquitectura
En esta configuración:
r=8determina el tamaño del espacio de correcciones; aumentarlo añade capacidad y parámetros, sin asegurar una mejora.target_modules=["query", "value"]elige esas proyecciones de atención del encoder. Los nombres cambian entre arquitecturas y no constituyen la única selección posible.lora_alpha=16da una escala16/8=2en LoRA estándar.lora_dropout=0.05aplica dropout en la ruta del adaptador al entrenar.modules_to_save=["cabeza"]mantiene entrenable y guarda la cabeza nueva de este wrapper. Sin esa indicación, PEFT la congela junto al modelo base. Configuración oficial de LoRA.
El optimizador se crea después de envolver el modelo, para incluir los adaptadores y la cabeza entrenable.
Qué parámetros se están adaptando
Revisa nombres y
requires_grad, no solo el porcentaje: adaptadores y cabeza nueva deben entrenarse; pesos del encoder base deben quedar congelados. Si ningúntarget_modulescoincide, PEFT lanzaValueError; no activa fine-tuning completo silenciosamente. Los nombres cambian entre arquitecturas. Antes de entrenar varias épocas, ejecuta un paso y comprueba que cambian tanto la cabeza como algún adaptador, y que el encoder base permanece intacto.
En LoRA se suelen explorar tasas mayores que en fine-tuning completo de un
encoder de texto; por ejemplo, 1e-4 a 3e-4 como candidatos iniciales.
La escala s, el rango y la tarea cambian esa comparación.
En la inicialización estándar de PEFT, A es aleatoria y B es cero; así B·A empieza en cero. Si ambas fueran cero, sus gradientes también
lo serían y no aprenderían. El mejor learning rate se elige con validación.
Fine-tuning parcial: elegir qué capas se mueven
Otra alternativa es congelar el encoder y habilitar gradientes solo en algunas
capas, manteniendo entrenable la cabeza nueva. La receta Congelar capas
ilustra ese patrón; identificar «las últimas capas» requiere conocer la
estructura concreta del encoder. Esta comparación también parte de un
Clasificador nuevo, sin los adaptadores del experimento anterior.
# bloque: fragmento
congelar(modelo.encoder)
descongelar_ultimas(modelo.encoder, n_capas=2)
Las últimas capas suelen estar más próximas a la salida de preentrenamiento, por lo que adaptarlas es una hipótesis razonable. La información está distribuida a través de la red: no existe una frontera universal entre capas «generales» y «específicas», y algunas tareas necesitan cambiar otras partes.
Crear el optimizador después de elegir las capas hace explícito qué parámetros
se actualizarán. El filtro selecciona aquellos cuyo requires_grad está activo:
# bloque: fragmento
optimizador = torch.optim.AdamW(
    filter(lambda p: p.requires_grad, modelo.parameters()), lr=2e-5)
Un optimizador que ya entrenó puede conservar estados de parámetros que luego
congelaste. Recrearlo con los entrenables hace explícita la nueva fase y evita
arrastrar ese estado. Incluir un parámetro congelado con gradiente None no
crea por sí solo nuevos estados en AdamW.
El olvido catastrófico
Al afinar un modelo en una tarea nueva, puede degradarse la anterior. Mover pesos hacia lo nuevo no garantiza conservar su comportamiento previo.
Eso fue una tarea entera: Operation Night Watch (IOAI 2026, at-home) pedía enseñarle 13 clases de sonido nuevas a un clasificador de audio ya desplegado sin que olvidara las 16 que ya sabía, y el puntaje era el promedio 50/50 entre la accuracy en las viejas y en las nuevas. Olvidar costaba exactamente lo mismo que no aprender.
Algunas estrategias para explorar:
- Congelar el encoder limita cambios en su representación. Agregar clases aún puede cambiar las predicciones porque compiten con las antiguas.
- LoRA conserva los pesos originales, pero el adaptador activo cambia la función: no garantiza ausencia de olvido. Mide ambas tareas también aquí.
- Mezclar los datos: entrenar con clases viejas y nuevas juntas.
- Limitar la tasa y la duración puede moderar los cambios, aunque también impedir aprender las clases nuevas. Su efecto sobre el olvido debe medirse.
Dos curvas separadas, una para clases antiguas y otra para nuevas, hacen visible el intercambio. Un promedio puede ocultar que toda la mejora de una mitad se obtuvo deteriorando la otra. Para mezclar datos antiguos, además, esos ejemplos tienen que estar disponibles y autorizados.
⚠️ Las otras dos trampas
1. Suponer que un id del Hub estará disponible. En modo offline puede
cargar si sus archivos completos están en caché; si faltan, falla. Usa las
rutas locales del enunciado y local_files_only=True, y verifica los
activos en una preparación separada antes del simulacro. Estar en caché no
significa estar permitido por la tarea.
2. Confundir entrenamiento previo con entrenamiento dentro del envío. Si el contrato vuelve a ejecutar un notebook que entrena, ese entrenamiento cuenta de nuevo al calificar, junto a carga e inferencia. Otros contratos aceptan pesos ya entrenados. El módulo 15 desarrolla cómo medir el flujo que realmente va a ejecutar el juez.
🏋️ Práctica
Primero, cambiar el rango
En el ejemplo de la figura, W transforma cuatro coordenadas en seis. Cambia el rango de LoRA de 2 a 1: escribe las formas de A y B y cuenta sus parámetros. ¿Cambia la forma de salida?
Para contrastar
A tiene forma 1×4 y B, 6×1: suman 10 parámetros frente a 20 con rango 2. La salida sigue teniendo seis coordenadas. La actualización tiene rango a lo más 1; reducir parámetros restringe qué cambios puede expresar, sin asegurar mejor validación.
Para profundizar
| # | Ejercicio | Fuente | Qué practica |
|---|---|---|---|
| 1 | ⭐ HuggingFace LLM Course, capítulos 3 y 11 (fine-tuning y PEFT) | huggingface.co/learn | la API, bien explicada |
| 2 | Clasifica tweets: encoder congelado vs. fine-tuning completo, mismo split | NLP Getting Started | medir cuánto aporta afinar |
| 3 | Repite el 2 con LoRA y compara puntaje, tiempo y memoria | Congelar capas | las tres dimensiones a la vez |
| 4 | ⭐⭐ Operation Night Watch: 13 clases nuevas sin olvidar 16 viejas | abrir en Colab | olvido catastrófico, tarea real |
| 5 | Bobai (2024): adaptar mBERT a una lengua que no conoce | .zip oficial | pre-entrenamiento continuado |
Una tabla con puntaje, tiempo y memoria permite comparar las tres estrategias bajo el mismo split. También ayuda a ver cuándo una mejora pequeña exige un costo desproporcionado.
🎯 Mini-desafío (formato IOAI)
Tarea: Ghost of the Machine (IOAI 2026, día 2). Métrica:
exp(−|predicho − real| / 100), promediada, ×100. Referencia histórica del split A oculto: baseline 28.6, Comité 93.41. En validación propia compara contra el baseline oficial ejecutado sobre el mismo split; esos números históricos no calibran otro conjunto. Modelo permitido: solobge-base-en-v1.5. Nada más. Tiempo: 10 minutos de ejecución, cubriendo entrenamiento e inferencia.El enunciado describe una solución del Comité que afina el encoder y busca un punto de cambio entre frases. Eso sugiere una familia de experimentos; no especifica todas las decisiones ni garantiza reproducir su score.
Una hipótesis inicial usa embeddings congelados por frase y busca cambios entre frases consecutivas. El contenido también puede cambiar dentro de un mismo autor: observar falsos positivos ayuda a decidir qué debería aprender el ajuste. Compara ese detector y sus variantes frente al baseline en el mismo split local reservado.
Para explorar
El laboratorio Una cabeza nueva y un adaptador que aprende permite observar estas matrices en un BERT diminuto local, sin descargar pesos.
Compara una capa base, su actualización B·A y el resultado de sumarlas.
¿Qué ocurre al apagar el adaptador después de entrenar, y qué parte del
clasificador nuevo necesitas conservar?
Traza por separado el desempeño en clases antiguas y nuevas. Congelar los pesos originales no congela la función cuando un adaptador sigue activo.
← 13 - Atención y Transformers · Ruta de Aprendizaje · 15 - Entrenar bajo presupuesto →