06 · Modelos clásicos
Nivel 1 — El piso · Ruta de Aprendizaje
Antes de empezar. Ajustar y predecir (02), métricas (04) y validación (05). Compararemos primero las reglas que cada modelo puede representar.
Dos modelos pueden recibir las mismas filas y aprender reglas distintas. Uno intenta resumir una tendencia con una recta; otro consulta vecinos; otro hace preguntas sucesivas. Cada familia permite ciertas formas de respuesta. Su capacidad describe, de manera general, cuánta variedad de relaciones puede representar. Más variedad permite captar patrones y también seguir ruido.
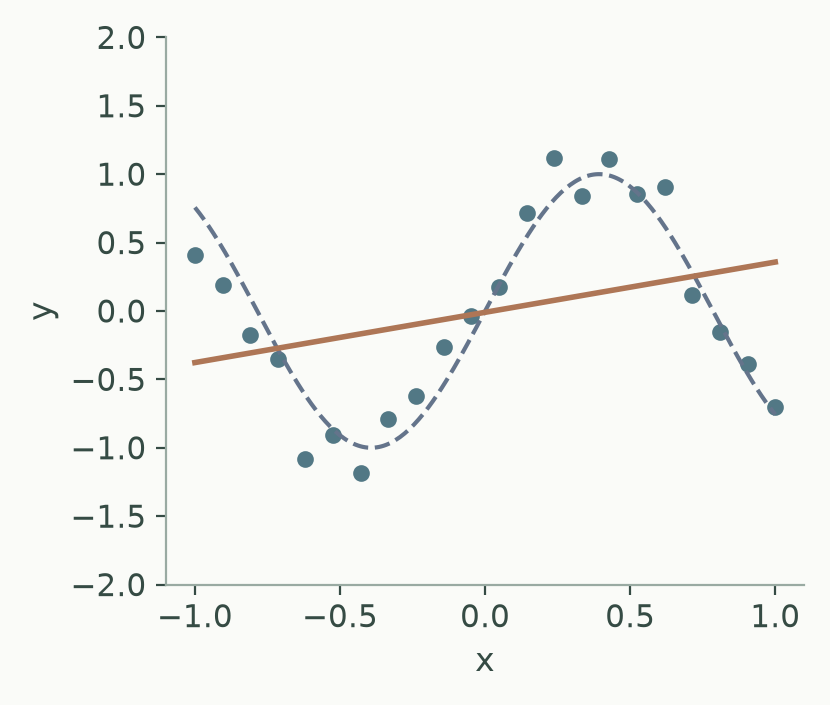
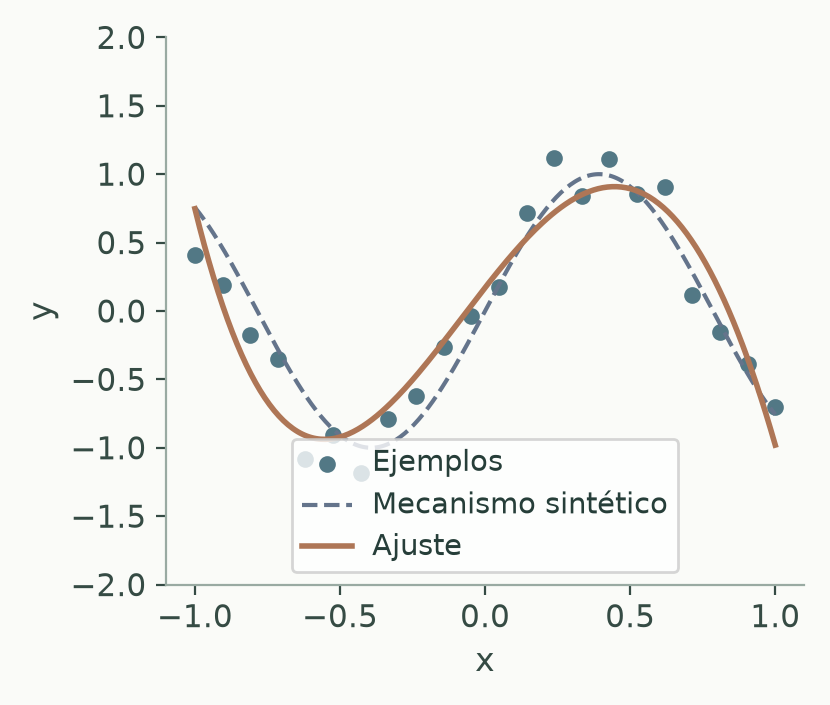
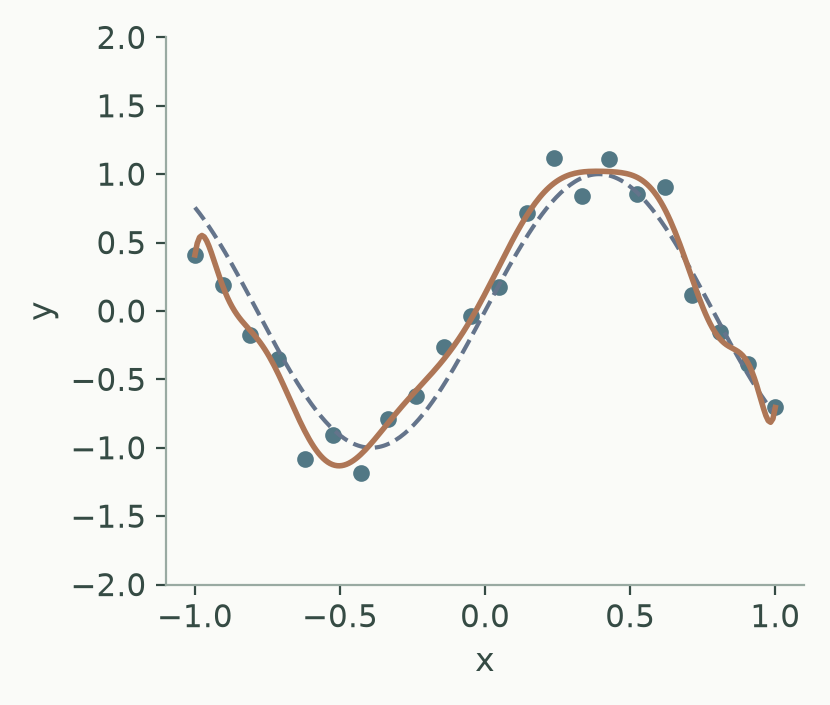
En la figura, una regla demasiado rígida pierde la curvatura. Una muy flexible puede seguir detalles accidentales. La forma que mejor ajusta los puntos observados no tiene por qué funcionar mejor fuera de ellos: por eso construimos la validación del módulo anterior.
Regresión lineal: combinar aportes
Una regresión lineal predice una cantidad sumando contribuciones de sus
variables. Con dos entradas, la regla es ŷ = w1×x1 + w2×x2 + b: el sombrero
indica una predicción, los w son pesos aprendidos y b desplaza el resultado.
Por ejemplo, tiempo = 2×distancia + 3 predice 11 minutos para distancia 4.
El coeficiente 2 representa el cambio por unidad de distancia dentro de esa regla.
El ajuste por mínimos cuadrados busca pesos que reduzcan el error cuadrático
de entrenamiento. La relación es lineal respecto de las variables entregadas.
Si añades distancia² como otra variable, puedes describir una curva en la
distancia original manteniendo una suma ponderada de features. Ser «lineal»
no significa que cualquier dibujo deba ser una recta en las coordenadas originales.
Con pocos datos, limitar la familia de reglas puede ayudar a evitar ajustes accidentales. Pero una recta también puede quedarse corta o sobreajustar si hay muchas variables: no generaliza por el nombre del modelo.
Regresión logística: convertir la combinación en una probabilidad
Para clasificación binaria, la logística toma z = w·x + b y aplica una
sigmoide, una curva suave que convierte cualquier número en un valor entre
cero y uno. Ese valor estima la probabilidad de la clase positiva:
import numpy as np

def sigmoide(z):
    return 1.0 / (1.0 + np.exp(-z))

print(sigmoide(np.array([-4.0, 0.0, 4.0])))  # aproximadamente [0.018, 0.5, 0.982]
En cero devuelve 0.5; números positivos elevan la estimación y negativos la
reducen. Con umbral 0.5, la frontera queda donde w·x+b=0: una recta para dos
variables originales, un plano para tres. El dibujo del módulo 02 mostraba
ese caso. Umbral óptimo permite explorar otras decisiones a partir de las
mismas estimaciones; su calibración es otra propiedad, explicada en el módulo 04.
Una sola recta no separa, por ejemplo, un círculo interior de un anillo exterior.
Podrías cambiar la representación —añadiendo x1²+x2²— o la familia de modelo.
Árboles, vecinos y SVM con kernel ya permiten relaciones no lineales; no hace
falta esperar a redes para encontrarlas.
Regularización: poner un precio a la flexibilidad
La pérdida mide el error que el procedimiento intenta reducir al entrenar. La regularización añade un término que favorece ciertas soluciones, aunque otra ajuste algo mejor los datos observados. En modelos lineales suele penalizar el tamaño de los pesos:
- L2 suma sus cuadrados. Favorece pesos pequeños sin buscar directamente que muchos sean exactamente cero.
- L1 suma sus valores absolutos. Puede dejar pesos exactamente cero y obtener una regla que usa menos variables.
Un peso grande no prueba que haya ruido: también depende de la unidad. El mismo efecto por metro necesita un coeficiente mil veces mayor si la entrada se expresa en kilómetros. Escalar hace más comparable la penalización entre variables, aunque no convierte sus coeficientes en importancia causal.
Estos objetos configuran distintas penalizaciones; todavía no están ajustados. El código usa la interfaz del Entorno de estudio, con scikit-learn 1.9:
from sklearn.linear_model import LogisticRegression

# C más pequeño da mayor peso relativo a la regularización.
suave = LogisticRegression(C=1.0, l1_ratio=0.0, max_iter=1000)
fuerte = LogisticRegression(C=0.01, l1_ratio=0.0, max_iter=1000)
disperso = LogisticRegression(C=0.1, l1_ratio=1.0, solver="liblinear", max_iter=1000)
l1_ratio=0 selecciona L2 y l1_ratio=1, L1; solver elige el algoritmo de
ajuste y debe ser compatible. C es un hiperparámetro: una elección del
experimento, distinta de los pesos que aprende fit.
Documentación de LogisticRegression.
Aumentar regularización puede reducir sobreajuste o quitar una señal útil; lo observamos con validación. Que L1 descarte una variable tampoco demuestra que sea irrelevante en general: otras variables correlacionadas pueden sustituirla. Elegir la penalización mirando todo el test seguiría contaminando la evaluación, aunque la selección ocurra dentro del modelo.
k-NN: preguntar a los ejemplos cercanos
Tenemos mediciones en una sola coordenada: 0 y 2 son de clase A; 3 y 8, de clase B. Para clasificar una medición nueva en 2.6, calculamos distancias:
| Medición conocida | Clase | Distancia a 2.6 |
|---|---|---|
| 0 | A | 2.6 |
| 2 | A | 0.6 |
| 3 | B | 0.4 |
| 8 | B | 5.4 |
Con un vecino gana B, el de 3. Con tres vecinos votan B, A y A: gana A. El punto nuevo no cambió; cambió cuánta vecindad consultamos. Esta cuenta usa votos con igual peso y evita empates de distancia y de votos.
k vecinos más cercanos busca los k ejemplos de entrenamiento más próximos
a una entrada y combina sus respuestas. En clasificación, pueden votar: si dos
de tres vecinos son de clase 1, gana esa clase. fit conserva ejemplos y puede
preparar una estructura de búsqueda; no resume todo en unos pocos coeficientes.
Esto plantea una pregunta previa: ¿qué significa cerca? La distancia numérica depende de las unidades. Cambiar kilómetros por metros puede dar mil veces más influencia a esa coordenada sin cambiar el fenómeno observado. k-NN con escalado usa un pipeline para controlar ese efecto. Si las unidades o los pesos ya expresan una distancia pertinente, la elección necesita contexto.
Con k=1, una etiqueta anómala puede cambiar la predicción de toda su vecindad.
Aumentar k promedia más casos y suele suavizar la frontera, pero también puede
borrar grupos pequeños con una señal real. El cuaderno permite mirar ese intercambio.
Árboles: dividir el espacio mediante preguntas
Usaremos las mismas cuatro mediciones, ordenadas: 0:A, 2:A, 3:B, 8:B.
Un corte en 2.5 deja A,A a un lado y B,B al otro: cada hoja puede predecir
una clase sin equivocarse en estas filas. Un corte en 1 deja A a un lado
y A,B,B al otro: la hoja derecha predice B y falla en la medición 2.
Para comparar cortes podemos medir la mezcla con Gini:
1 − proporción_A² − proporción_B². Una hoja pura tiene Gini 0;
la hoja A,B,B tiene 1−(1/3)²−(2/3)²=4/9. Ponderamos por cuántas filas
recibe cada hoja: el corte en 1 tiene impureza 1/4×0 + 3/4×4/9 = 1/3;
el corte en 2.5 tiene cero. En este caso, reducir la impureza elige 2.5.
Es un criterio de entrenamiento; no prueba que el corte generalice.
# bloque: probado; id: vecinos_y_arbol
import numpy as np
from sklearn.neighbors import KNeighborsClassifier
from sklearn.tree import DecisionTreeClassifier

mediciones = np.array([[0.], [2.], [3.], [8.]])
clases = np.array([0, 0, 1, 1])   # A=0, B=1
consulta = [[2.6]]
votos = []
for k in [1, 3]:
    vecino = KNeighborsClassifier(n_neighbors=k).fit(mediciones, clases)
    votos.append(int(vecino.predict(consulta)[0]))
arbol = DecisionTreeClassifier(max_depth=1, random_state=0).fit(mediciones, clases)
print(votos)                              # [1, 0]
print(arbol.tree_.threshold[0])           # 2.5
print(arbol.predict([[2.], [2.6]]))       # [0, 1]
En este árbol, predecir 2.6 consiste en una pregunta: ¿es menor o igual que 2.5? Como no, vamos a la hoja B. Si esa hoja mezclara clases, una segunda pregunta podría subdividirla; el ajuste se repite dentro de cada rama.
Un árbol decide con preguntas como temperatura > 20 y, dentro de una rama,
lluvia > 50. Cada camino termina en una hoja, cuya predicción se aprende
de los ejemplos que llegaron allí. Con dos variables, esos cortes dibujan
regiones alineadas con los ejes.
La segunda pregunta puede depender de la primera: así aparece una interacción entre variables. Como cada corte compara valores de una sola columna, cambiar sus unidades mediante una escala positiva no exige estandarizar para preservar su orden. Un árbol profundo permite regiones pequeñas y detalladas; también puede ajustarse a casos que no se repitan. Limitar profundidad o pedir más muestras por hoja cambia esa flexibilidad.
SVM: separar dejando margen
Imagina una frontera con una franja libre a cada lado. Una SVM intenta
obtener una separación con margen amplio; cuando no es posible separar todos
los puntos, permite violaciones y las penaliza. Los vectores de soporte
determinan esa frontera: pueden estar sobre el margen o violarlo, incluso
quedar clasificados del lado incorrecto. C controla el compromiso entre
regularización y penalización de esas violaciones.
Un kernel define cómo comparar entradas para construir esa separación.
Con rbf, la semejanza disminuye con la distancia y la frontera puede ser curva.
gamma controla la escala de esa semejanza; valores grandes pueden volverla
muy local. Esta es una configuración para explorar, no un modelo ya entrenado:
from sklearn.svm import SVC
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler

modelo = make_pipeline(StandardScaler(), SVC(C=1.0, kernel="rbf", gamma="scale"))
La escala de las variables afecta la geometría, por lo que estandarizar suele
ser una buena referencia. El ajuste de SVC con kernel puede crecer mucho al
aumentar las filas; eso no se aplica de la misma manera a implementaciones
lineales como LinearSVC. Conviene medir el coste del caso concreto.
Guía de SVM de scikit-learn.
Comparar formas de equivocarse
| Lo observado | Una hipótesis que vale la pena explorar |
|---|---|
| Error alto en train y validación | La representación o familia no captura la relación; también puede haber ruido o un ajuste incompleto |
| Error bajo en train y mayor en validación | La regla podría estar siguiendo detalles del entrenamiento; revisar además distribución, partición y tamaño de muestra |
| Errores bajos y parecidos | Evidencia favorable en esos datos; todavía falta observar la propuesta reservada fuera de las decisiones de selección |
Underfitting describe un ajuste insuficiente de la relación; overfitting, un ajuste a particularidades que no generalizan. Los dos errores orientan hipótesis, no un diagnóstico infalible. Mirar qué ejemplos fallan puede revelar algo que una media oculta.
También importa si el algoritmo terminó su ajuste. ConvergenceWarning
indica que no alcanzó el criterio de parada solicitado. Aumentar max_iter
puede ayudar, pero conviene revisar escala, regularización y algoritmo; más
iteraciones no reparan automáticamente todos esos problemas. Convergencia
numérica tampoco garantiza buen rendimiento fuera del entrenamiento.
Un experimento para mirar
Primero cambia la consulta a 1.9 y calcula sus tres vecinos sin ejecutar. Después cambia la clase de la medición 2 a B: ¿dónde pondrías ahora un corte que deje hojas puras? Contrasta con el código.
Para contrastar
Para 1.9 los vecinos son 2:A, 3:B y 0:A: gana A con k=1 y k=3. Tras cambiar la etiqueta de 2, un corte entre 0 y 2 separa A de B,B,B; el árbol usa el punto medio 1. La etiqueta de una sola fila cambió su regla.
El cuaderno 05 · Modelos y clustering de Laboratorios guiados dibuja las fronteras de un baseline, logística, k-NN, árbol y SVM en el mismo split. ¿Dónde cambia la frontera al mover k, profundidad o C? ¿Qué errores desaparecen y cuáles aparecen? Son controles sobre ideas distintas, no una sola escala de «más potente».
Su segunda parte enlaza con 08 - Sin etiquetas: K-means, DBSCAN, jerárquico y espectral proponen nociones distintas de grupo. Los clasificadores de este capítulo, junto con L1/L2, tienen alcance teórico y práctico en el Syllabus IOAI; no son los únicos temas para los que importa comprender el mecanismo.
Una pregunta conduce al módulo 07: si una regla depende mucho de los ejemplos concretos que recibió, ¿qué ocurre al combinar varias reglas? Los ensambles y el Gradient boosting tabular exploran esa posibilidad.
← 05 - Validación honesta · Ruta de Aprendizaje · 07 - Ensambles y gradient boosting →