00 · De programar a programar con datos
Nivel 1 — El piso · Ruta de Aprendizaje
Un programa puede recorrer cien precios uno por uno. También puede tratarlos como un solo arreglo y preguntar «¿cuáles superan 100?». NumPy es la biblioteca de Python que permite expresar esas operaciones sobre arreglos numéricos. La idea nueva es mirar a la vez los valores y su organización: una fila puede ser un ejemplo; una columna, una variable medida en él.
Los bloques de este capítulo continúan unos a otros; puedes ejecutarlos en orden en un notebook del Entorno de estudio.
Del ciclo al arreglo
Una lista de Python y un arreglo de NumPy no tienen las mismas operaciones.
[1,2]+[3,4] concatena listas y produce [1,2,3,4]; sumar los arreglos
correspondientes da [4,6], posición a posición. Un arreglo tiene una forma
y un tipo de representación numérica comunes a sus elementos.
import numpy as np

precios = np.array([80, 150, 60, 210])
suma = 0
for precio in precios:
    if precio > 100:
        suma += precio
print(suma)                          # 360
np.array construye un arreglo. En este caso es una secuencia de cuatro
enteros, parecida a una lista, pero sus operaciones numéricas actúan sobre
todos los elementos:
mas_de_cien = precios > 100         # [False, True, False, True]
seleccionados = precios[mas_de_cien] # [150, 210]
print(seleccionados.sum())          # 360, el mismo resultado
La condición produce una máscara booleana: un sí o no por posición. Indexar con esa máscara conserva las posiciones verdaderas. Esto se llama vectorizar: expresar la operación sobre arreglos en vez de recorrerlos explícitamente en Python. NumPy ejecuta muchas de esas operaciones en código compilado; puede ser mucho más rápido, aunque la diferencia depende del tamaño, el tipo de dato, la operación y el equipo. Los ciclos siguen siendo útiles cuando describen bien el problema.
La forma cuenta qué hay en cada eje
X = np.array([[1., 5., 20.],
              [3., 7., 10.],
              [5., 9., 30.],
              [7., 11., 40.]])
print(X.shape)   # (4, 3): cuatro filas, tres columnas
print(X.ndim)    # 2: dos ejes
print(X.dtype)   # float64: representación numérica de sus elementos
shape es la forma: el tamaño de cada eje. Si las filas son ejemplos,
(100, 3) significa cien ejemplos con tres variables cada uno. No expresa
lo mismo que (3, 100), aunque ambos arreglos guarden trescientos números.
La media puede responder preguntas distintas según el eje que reduzcas:
La media suma los valores y divide por cuántos hay. Para la primera
columna: (1+3+5+7)/4=4. Para la primera fila: (1+5+20)/3=26/3.
Una reducción resume varios valores en uno: al reducir el eje de filas,
queda un resultado por columna. Los ejes se numeran desde cero.
print(X.mean())          # 12.333...: una media de los doce valores
print(X.mean(axis=0))    # [4., 8., 25.]: una media por columna
print(X.mean(axis=1))    # [8.666..., 6.666..., 14.666..., 19.333...]: por fila
Con axis=0 recorres las filas para resumir cada columna; desaparece ese eje
y quedan tres valores. Con axis=1 resumes cada fila y quedan cuatro. Esta regla
supone la opción predeterminada keepdims=False; keepdims=True conserva
el eje reducido con tamaño uno.
Broadcasting: repetir una operación sin copiar la tabla
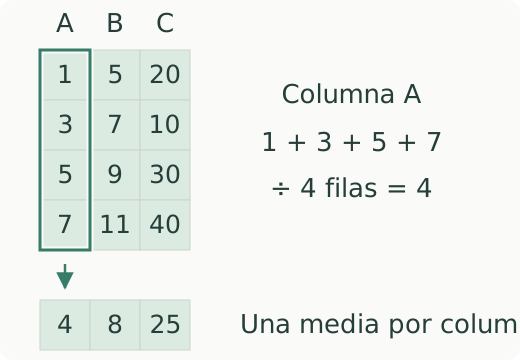
En la columna A, (1 + 3 + 5 + 7) / 4 = 4. Las medias de A, B y C son 4, 8 y 25; no se mezclan columnas.
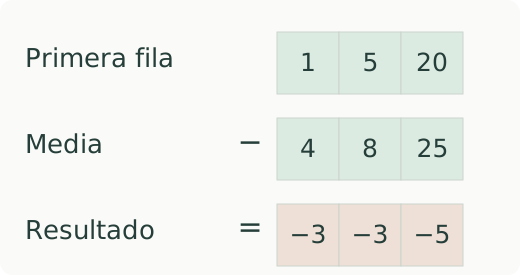
La primera fila pasa de [1, 5, 20] a [−3, −3, −5]: cada valor resta la media de su propia columna.
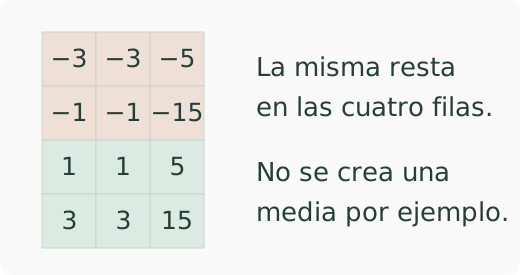
Broadcasting reutiliza la forma (1, 3) al operar con (4, 3). El resultado conserva cuatro filas y tres columnas; la media de cada columna queda en cero.
Queremos restar a cada columna su propia media. El arreglo de medias tiene
forma (3,) y la tabla (4, 3):
media = X.mean(axis=0)
centrada = X - media
print(centrada)
# [[-3., -3.,  -5.],
#  [-1., -1., -15.],
#  [ 1.,  1.,   5.],
#  [ 3.,  3.,  15.]]
Broadcasting permite usar las mismas tres medias en las cuatro filas, sin que tú construyas una copia por fila. Las dimensiones se comparan de derecha a izquierda: deben ser iguales o una de ellas debe valer uno; las dimensiones iniciales ausentes se tratan como unos.
Podemos ver la misma operación con ciclos. Para la casilla de fila i y columna j usamos la media de la columna j, sin cambiarla entre filas:
centrada_con_ciclos = np.empty_like(X)
for i in range(X.shape[0]):
    for j in range(X.shape[1]):
        centrada_con_ciclos[i, j] = X[i, j] - media[j]
assert np.allclose(centrada_con_ciclos, centrada)
empty_like reserva un arreglo de la misma forma y tipo; llenamos todas sus
casillas antes de leerlas. allclose compara con tolerancia para redondeos.
X-media expresa esa misma intención sin escribir el recorrido.
Restar la media se llama centrar. Si además divides por la desviación
estándar de cada columna, obtienes una estandarización: valores expresados
en unidades de dispersión respecto de su media. Por ejemplo, 2 significa
«dos desviaciones por encima de la media», no dos unidades originales.
Para [1,3,5,7], la media es 4 y las diferencias son [−3,−1,1,3].
Promediarlas daría cero por cancelación. Sus cuadrados son [9,1,1,9];
la media de esos cuadrados es 5, la varianza poblacional. Su raíz,
√5≈2.236, es la desviación estándar, en las unidades originales.
Estandarizar el primer valor da (1−4)/√5≈−1.342.
desviacion = X.std(axis=0)               # dispersión por columna, ddof=0
# Una columna constante tiene desviación 0: usar divisor 1 evita 0/0.
divisor = np.where(desviacion > 0, desviacion, 1.0)
estandarizada = (X - media) / divisor
print(np.round(estandarizada, 3))
# [[-1.342, -1.342, -0.447],
#  [-0.447, -0.447, -1.342],
#  [ 0.447,  0.447,  0.447],
#  [ 1.342,  1.342,  1.342]]
np.where(condicion, si_se_cumple, si_no) elige por posición: conserva la
desviación positiva y usa 1 para una columna constante. ddof=0 divide la
suma de cuadrados por n; la corrección muestral ddof=1 dividiría por n−1.
Aquí estamos describiendo los datos dados. Normalización también nombra otros
cambios de escala. Cuando separes entrenamiento y validación, estas estadísticas se
aprenderán solo del primero; por ahora observamos la operación sobre una matriz.
Una forma válida puede responder otra pregunta
reshape(3,1) organiza tres números en tres filas y una columna. Escribir
reshape(-1,1) pide inferir cuántas filas hacen falta, conservando la cantidad
de valores. Vectores y operaciones con sentido desarrolla esta diferencia
entre un vector (3,), una columna (3,1) y una fila (1,3).
v = np.array([1., 2., 3.])  # (3,): un vector
c = v.reshape(-1, 1)        # (3, 1): los mismos valores como columna
print(v + c)
# [[2., 3., 4.],
#  [3., 4., 5.],
#  [4., 5., 6.]]
La matriz contiene todas las sumas por pares. Es exactamente lo que
necesitas si esa era la pregunta. Si querías sumar cada elemento consigo
mismo y obtener [2,4,6], necesitabas v + v. NumPy puede comprobar
compatibilidad de formas, pero no tu intención: mirar el resultado permite
reconocer cuál de las dos operaciones escribiste.
Contar aciertos también es operar con un arreglo
verdaderos = np.array([0, 1, 1, 0])
predicciones = np.array([0, 0, 1, 0])
aciertos = predicciones == verdaderos   # [True, False, True, True]
print(aciertos.sum())                   # 3
print(aciertos.mean())                  # 0.75
Al sumar booleanos, True cuenta como uno y False como cero. Su media es la
fracción de aciertos, llamada accuracy. Una operación de NumPy acaba de
convertirse en una medida de un predictor; el módulo 04 examina qué deja fuera.
Copias, tipos y azar
Un recorte puede compartir memoria con su origen:
a = np.array([1, 2, 3])
b = a[:2]       # vista: comparte esos elementos con a
b[0] = 99
print(a)        # [99, 2, 3]
copia = a[:2].copy()  # esta sí tiene sus propios datos
También importa cómo se representan los valores. Los enteros de tamaño fijo tienen un rango limitado:
print(np.array([2**31 - 1], dtype=np.int32) * 2) # [-2]: desbordamientoPara escalar imágenes de enteros entre 0 y 255 suele ser útil convertir a
float32 antes de operar. Para conteos exactos grandes, elige una representación
con rango suficiente: pasar a coma flotante también limita la precisión.
Por último, una semilla inicia un generador de números pseudoaleatorios. Permite repetir, por ejemplo, el mismo orden de filas:
rng = np.random.default_rng(42)
orden = rng.permutation(6)
repetido = np.random.default_rng(42).permutation(6)
assert np.array_equal(orden, repetido)
Esto ayuda a comparar variantes con el mismo azar. No garantiza resultados idénticos entre todas las versiones y dispositivos ni demuestra que una conclusión se sostenga con otras muestras.
Un experimento para mirar
En el cuaderno 00 · NumPy y formas de Laboratorios guiados puedes comparar la normalización por ciclos y por arreglos. Cambia una columna de metros a centímetros, agrega una columna constante o deja una sola fila. ¿Qué cambia en la figura y qué forma conserva la salida? Una columna constante termina en ceros: no puede tener, además, desviación uno.
numpy-100 ofrece exploraciones opcionales en inglés. La plantilla de competencia está disponible más adelante desde Entorno de estudio; no hace falta preparar un concurso para probar estas ideas.
Ya puedes operar sobre una tabla. La siguiente pregunta es qué significa cada fila y cada columna, y qué información falta: eso añade pandas.
← Python para leer los ejemplos · Ruta de Aprendizaje · Vectores y operaciones con sentido →